Go TaaS:把算力变成 Token 工厂的开源底座
本文转载自公众号「AI Infra 源码分析」,原文《Go TaaS:把算力变成 Token 工厂的开源底座》。
作为云计算从业者,过去十年,我们习惯用资源描述基础设施:多少核、多少 GB 内存、多少张卡。客户也习惯这样买。但在推理成为主要负载之后,资源不再是交付物,Token 才是。资源只是生产 Token 的原材料。
Go TaaS 是我们基于这样的判断做的一个 AI Native 的开源项目:Apache-2.0 License,跑在 Kubernetes 上,把模型部署、异构加速卡调度、Token 计量、计费结算和路由治理做成可私有化部署的底座。它不是又一个 MaaS 平台,而是一座能自己运营的 Token 工厂。
之所以称之为 AI Native 的项目,是因为这个项目我只做了架构设计和 CI/CD 流水线的搭建,剩下的功能探索、设计、文档、编码都是 AI 小团队完成的。AI Coding 发展到今天,模型编码的能力已经达到甚至超过很多人类工程师的水平,我们 Review 的速度已经远远赶不上代码生成的速度。所以我们把这个项目开源出来,希望更多的伙伴参与进来,给 AI 上 Harness、Review 代码、在真实的集群上验证,用一种全新的开发方式共同建设一座开放的企业级 Token 工厂。
01 / Abstraction:从云计算到 AI,基础设施的演进
IaaS → PaaS → SaaS | ML Platform → MaaS → TaaS
如果把过去二十年压缩成一条线,大致是这样一个顺序:2006 年前后,IaaS 把虚拟化的计算、存储和网络当成资源出租;2010 年前后,PaaS 把运行时、数据库和中间件托管起来,开发者只交代码;2015 年前后,SaaS 把业务功能直接做成应用,用户按席位付费。这三个阶段大家都熟,不必展开。
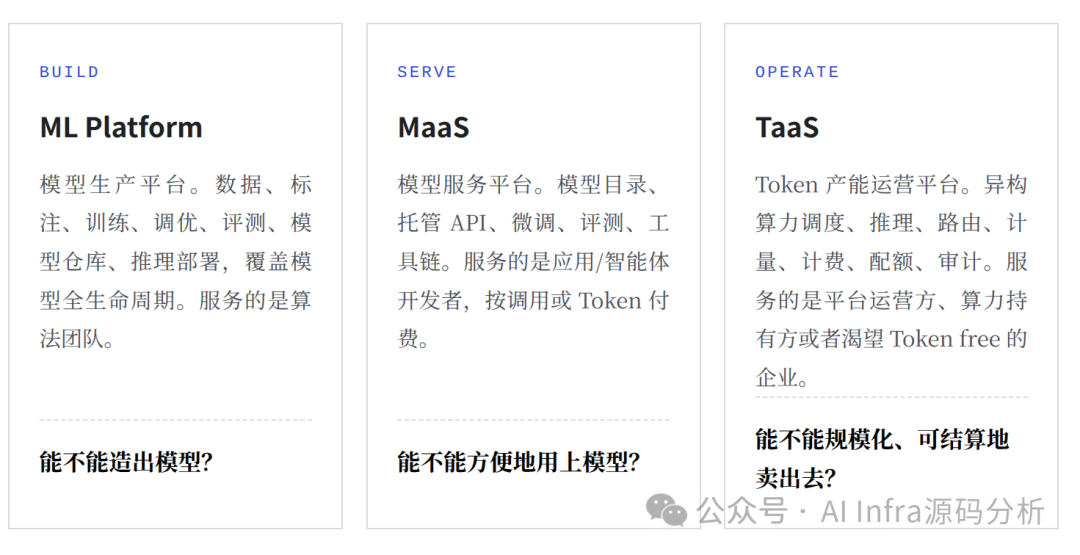
AI 时代多出来的三层,性质不太一样。2018 年前后的 ML Platform 解决的是能不能造出模型,覆盖数据、标注、训练、调优、评测、模型仓库与推理部署;2023 年前后的 MaaS 解决的是能不能方便地用上模型,把训练好的模型以托管 API 提供,附带模型目录、微调和工具链;2025 年之后出现的 TaaS,解决的是能不能规模化、低成本、可结算地把 Token 卖出去。
这三层不是简单替换前两层。云时代,算力持有方把资源卖给云厂商,云厂商自己完成运营;AI 时代,算力散落在 IDC、运营商、行业云和一堆异构集群里,中间需要一个运营层,把卡变成可计量的 Token。TaaS 就是这一层。
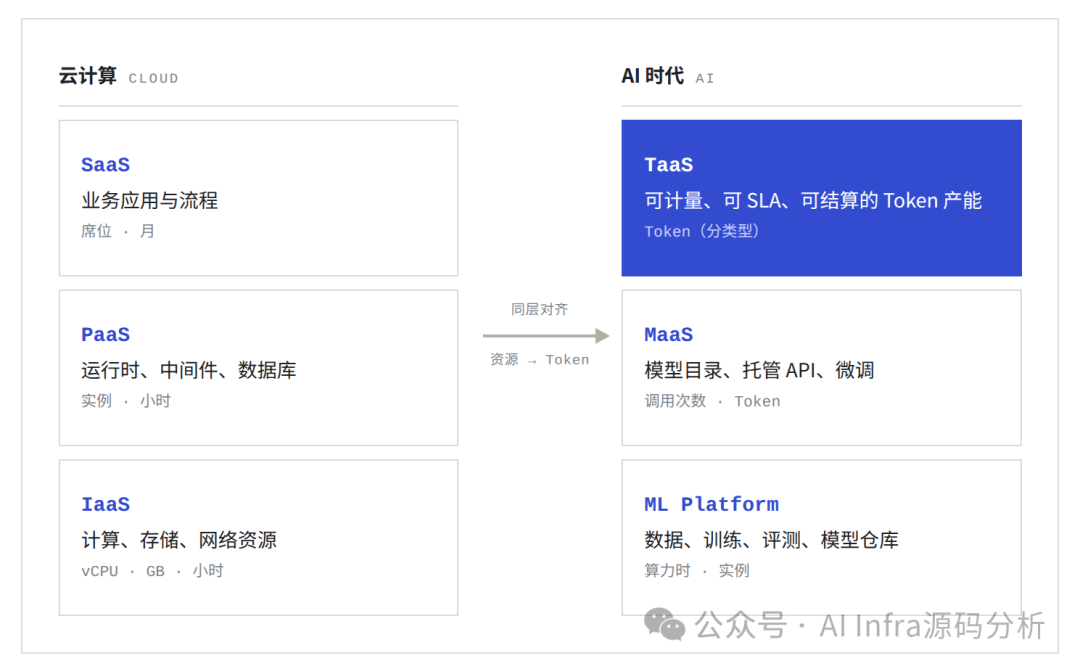
图 1:左边是云计算的三层,右边是 AI 时代对应的三层,两边自上而下都是业务价值 → 资源。同一行的两者处于同一抽象层级,中间的箭头表示交付物与计量单位的变化,不是技术替代。
把同一行的两个框横着读,会发现三件事在同时变化:交付物、计量单位、买家。
交付物从资源变成能力,再变成承诺。 最下面一行,IaaS 交付一台机器,ML Platform 交付一套训练与评测能力;中间一行,PaaS 交付一个运行环境,MaaS 交付一组模型 API;最上面一行,SaaS 交付业务功能,TaaS 交付的是一段时间内稳定输出的 Token,以及围绕它的 SLA、配额和账单。客户买的不是我有多少卡,而是你保证我每月能用多少 Token,延迟上限多少,故障怎么赔。
计量单位从时间、席位,变成调用与 Token。 按时间计费的问题,是时间和业务价值弱相关:一个客户跑了十小时可能只发了一百个请求,另一个客户同样十小时发了一百万个。按调用次数计费,又无法区分长短请求。Token 同时反映输入长度、输出长度、缓存命中与推理深度,是目前最接近智能用量的度量。它不完美——不同 tokenizer 的计数不同,图片、音频的计量还在演化——但在工程上,它比其它口径更可解释,也更容易做进合同。
买家从 IT 部门变成开发者,再变成 Agent 和平台运营方。 这一条最容易被忽略。当调用方是 Agent,它不看你的控制台做得漂不漂亮。它只感知三件事:API 稳不稳、错误码清不清楚、限流会不会把它打死。这直接决定了 TaaS 的架构重心在数据面,不在界面。
TaaS 不是 MaaS 上面再叠一层。现实里,MaaS 可以直接跑在 IaaS 上,不经过 ML Platform;TaaS 也可以自带模型目录和 Playground,看起来像 MaaS。图上的上下关系表示价值抽象,不是调用顺序,也不是部署依赖。判断一个平台属于哪一层,看两件事:谁付钱,考核什么指标。
02 / Capital:资本为什么在这个时间点涌向 Token 工厂
先把时间线摆出来。以下数字来自公开报道,口径并不统一,但方向足够清楚。
| 时间 | 公司 | 轮次 | 金额 | 备注 |
|---|---|---|---|---|
| 2026-05 | 无问芯穹 | 新一轮 | 超 7 亿元 | 杭州高新金投、惠远资本领投;累计超 22 亿元 |
| 2026-06 | 硅基流动 | B 轮 | 超 20 亿元 | 据 36 氪报道,估值 77.4 亿元 |
| 2026-07 | 趋境科技 | A 轮 | 半年超 10 亿元 | 河南投资集团汇融基金领投 |
| 2026-10 | 无问芯穹 | C 轮 | 23 亿元 | 累计 43 亿元;据彭博社,已保密递表港交所 |
数据来源:公开报道,截至 2026 年 10 月。不同来源的融资金额与估值口径未统一,仅用于判断方向。
无问芯穹这一轮最值得看。投资方名单里有国资机构、腾讯、百度、红杉中国、启明创投、顺为资本等;它不碰芯片,也不碰模型,做的是中间那层异构算力调度,把不同架构的卡统一纳管,再把 Token 当电卖。按公开说法,平台适配了 16 种芯片、服务 37,000P 算力,新芯片的适配周期约两个工作日,千卡异构混合训练的系统利用率达到 97.6%。这些数字都是厂商自述,但方向很明确:算力越碎,中间层越值钱。
海外市场给的估值更夸张。做同一门生意的 Fireworks AI,一年内估值从 40 亿美元涨到 175 亿美元;Baseten 涨了 160%,Together AI 涨了 151%。三家背后都有英伟达。卖铲子的公司亲自下场押注下游,说明它判断推理需求还会继续放大。
背后是技术发展方向判断
- 推理负载超过训练。 训练是一次性资本开支,推理是每天开门就要烧的电费。当推理成为主要成本项,企业会像优化供应链一样优化 Token 生产:批处理、缓存、路由、量化,能省一点是一点。
- 模型商品化。 开源模型在多数场景逼近闭源,模型性能与数量不再是壁垒。竞争点回到单位 Token 成本、首 Token 延迟、稳定性和芯片覆盖。模型厂商打得越凶,中间层的调度和优化越有价值。
- Agent 与长上下文。 一个 Agent 任务背后是几十次推理调用,多轮对话、工具调用、长文档、推理 Token 把单次请求的消耗成倍放大。按无问芯穹公开的说法,其平台日均 Token 使用量半年增长超过 40 倍,95% 以上的推理任务来自 Agent。厂商的说法未经证实,但和我们看到的流量结构一致。
- 算力异构与碎片化。 NVIDIA、昇腾、沐曦、摩尔线程、海光、寒武纪等多种加速卡并存,指令集、内存模型、编译器都不一样。算力持有方需要一层软件做统一纳管、调度和计量,否则无法对外提供标准的 Token 服务。这是 TaaS 存在的物理基础。
- 从试点走向生产。 试点阶段,客户能忍受手工部署和 Excel 对账;进入生产,SLA、多租户、配额、审计、发票,一样都不能少。只提供 API 的模型演示平台过不了采购这一关。
堆卡不等于产能
Token 工厂不是买卡开机就能赚钱。先看单位成本:
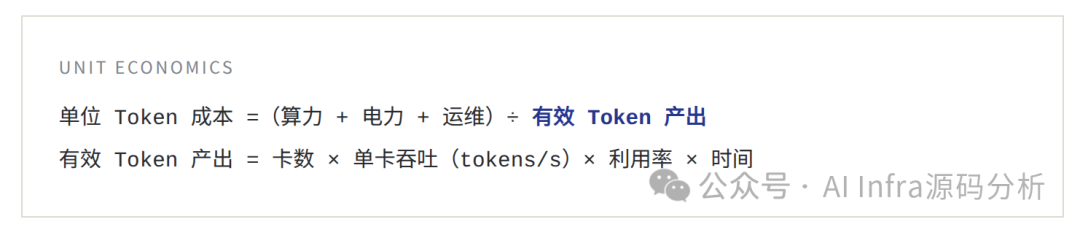
分母是有效产出,不是卡的数量。举个具体的例子:一个 8 卡实例,假设聚合输出吞吐 2,000 tokens/s。注意这是整个实例的总吞吐,不是单个请求的速度。单请求解码约 50 tokens/s,所以并发大约是 2,000 ÷ 50 = 40 个请求同时在生成。平均每个请求输出 1,000 tokens,生成需要 20 秒,加上首 Token 等待约 0.8 秒,驻留时间约 21 秒。用 Little’s Law 校验:到达率 2,000 ÷ 1,000 = 2 请求/秒,2 × 21 ≈ 42,和 40 基本吻合。
成本这边,2,000 tokens/s 跑满一小时是 720 万 tokens。30 元/小时除以 7.2 百万,约 4.2 元/百万 Token。这是 100% 利用率;按日均 70% 的有效利用率,成本会升到约 6.0 元。利用率对单位成本的影响是直接的,不需要复杂的模型就能看出来。
所以堆卡和产能是两件事。卡在排队、显存碎片、批处理没做好,有效产出可能只有峰值的一半。TaaS 的成本优化,主要不是采购问题,是工程问题:批处理、前缀缓存、PD 分离、弹性伸缩、路由。买更便宜的卡当然有用,但它的上限很清楚;把分母做大,空间反而更大。
中间层的三道坎
写到这里,需要泼一点冷水。资本密集进入,不等于这门生意已经跑通。
- 价格战。 上游算力紧缺,下游 Token 越来越便宜,中间层被两头挤压。行业内已经开始讨论词元通胀:Token 越来越多、越来越便宜,薄利多销很容易变成越卖越亏。
- 模型迭代速度。 工厂最怕产品天天变,今天刚调好的产线,明天新架构出来就要推倒重来。
- 异构这个前提本身。 无问芯穹的首席科学家戴国浩博士公开承认过三条挑战:算力资源碎片化、推理成本高、模型迭代快对架构灵活性要求高。这三条不是客套,是这门生意的软肋。
更长远地看,中间层公司一直不好做。云计算时代也有一批做多云管理、异构调度的公司,最后要么被收购,要么被上游吞掉。原因不复杂:上游想自己把控生态,下游想直接找源头。中间层要么做大成平台,要么退成软件,给掌握产能的人做底座。
Go TaaS 选后者。我们不打算再做一个通用 MaaS,也不打算自己囤卡卖 Token。我们做的是可私有化部署的 Token 工厂底座:部署、调度、计量、计费、路由、治理。帮助有算力、有客户、有场景的企业把算力变成可运营 Token 服务的软件能力。
03 / Definitions:ML Platform、MaaS、TaaS 的边界
这三个词经常被混着用。但其实它们是不同的平台,解决的是不同的问题。
| 维度 | ML Platform | MaaS | TaaS |
|---|---|---|---|
| 抽象对象 | 训练任务、实验、模型版本 | 模型 API、模型目录 | Token 产能、推理服务、租户与账单 |
| 核心交付 | 模型资产与训练能力 | 模型访问能力 | 可计量的 Token 供给 + 运营能力 |
| 计量单位 | 算力时 / 实例时 | 调用次数 / Token | Token(输入、输出、缓存、推理分类型) |
| 主要用户 | 算法 / ML 工程师 | 应用开发者 | 平台运营方、企业 IT、算力持有方 |
| 成功指标 | 训练效率、GPU 利用率、迭代速度 | 模型覆盖、可用性、调用量 | 单位 Token 成本、产能利用率、毛利率、SLA |
| 技术栈 | K8s、Ray、Kubeflow、训练框架 | 推理集群、模型网关、微调、RAG | 异构算力调度、推理引擎、计量计费、可观测性、成本优化 |
如何判断一个平台是不是 TaaS
- 是否按 Token 计量,且区分输入、输出、缓存与推理 Token?
- 是否多租户隔离,密钥、配额、数据边界清晰?
- 是否有配额、余额、账单与结算闭环?
- 是否有可承诺的 SLA,并与模型、卡型、上下文长度绑定?
- 是否以单位 Token 成本为核心 KPI,而不是调用量?
第三和第五个问题最容易被跳过。没有账单闭环,平台就无法对外营业;只考核调用量,团队最后一定会走到降价换量。必须同时看单位成本、利用率和毛利,才可能做成生意。
四个常见误区
| 说法 | 实际情况 |
|---|---|
| 有 OpenAI 兼容 API 就是 TaaS | API 兼容只是接入层。没有计量、隔离、结算和成本运营,它只是一个模型代理。 |
| TaaS 就是 MaaS 改名 | 前者卖产能与确定性,KPI 是成本、利用率、毛利;后者卖模型访问,KPI 是调用量。 |
| 必须自研推理引擎 | 不必。引擎在快速商品化,壁垒在参数调优、异构适配、验证矩阵和运营经验。 |
| 模型越多越好 | 长尾模型的显存、镜像、运维成本很高。模型数量是获客手段,不是壁垒。 |
把这三个概念压成一句话:ML Platform 卖工具与算力,MaaS 卖模型访问,TaaS 卖可承诺的产能。 这个承诺包含 SLA、配额、账单准确性,也包含故障时的赔付。它是 TaaS 和 API 代理最本质的区别。
也正因如此,TaaS 的一等公民不是模型,是部署、租户、价格和账本。一个 MaaS 平台可以只有一个模型、一千个开发者;一个 TaaS 平台可能一个模型都没有,但它必须知道每个租户用了多少 Token、成本多少、什么时候该限流、故障时怎么赔。
04 / Architecture:Go TaaS 的技术架构
把不确定的算力,变成可以承诺的 Token。
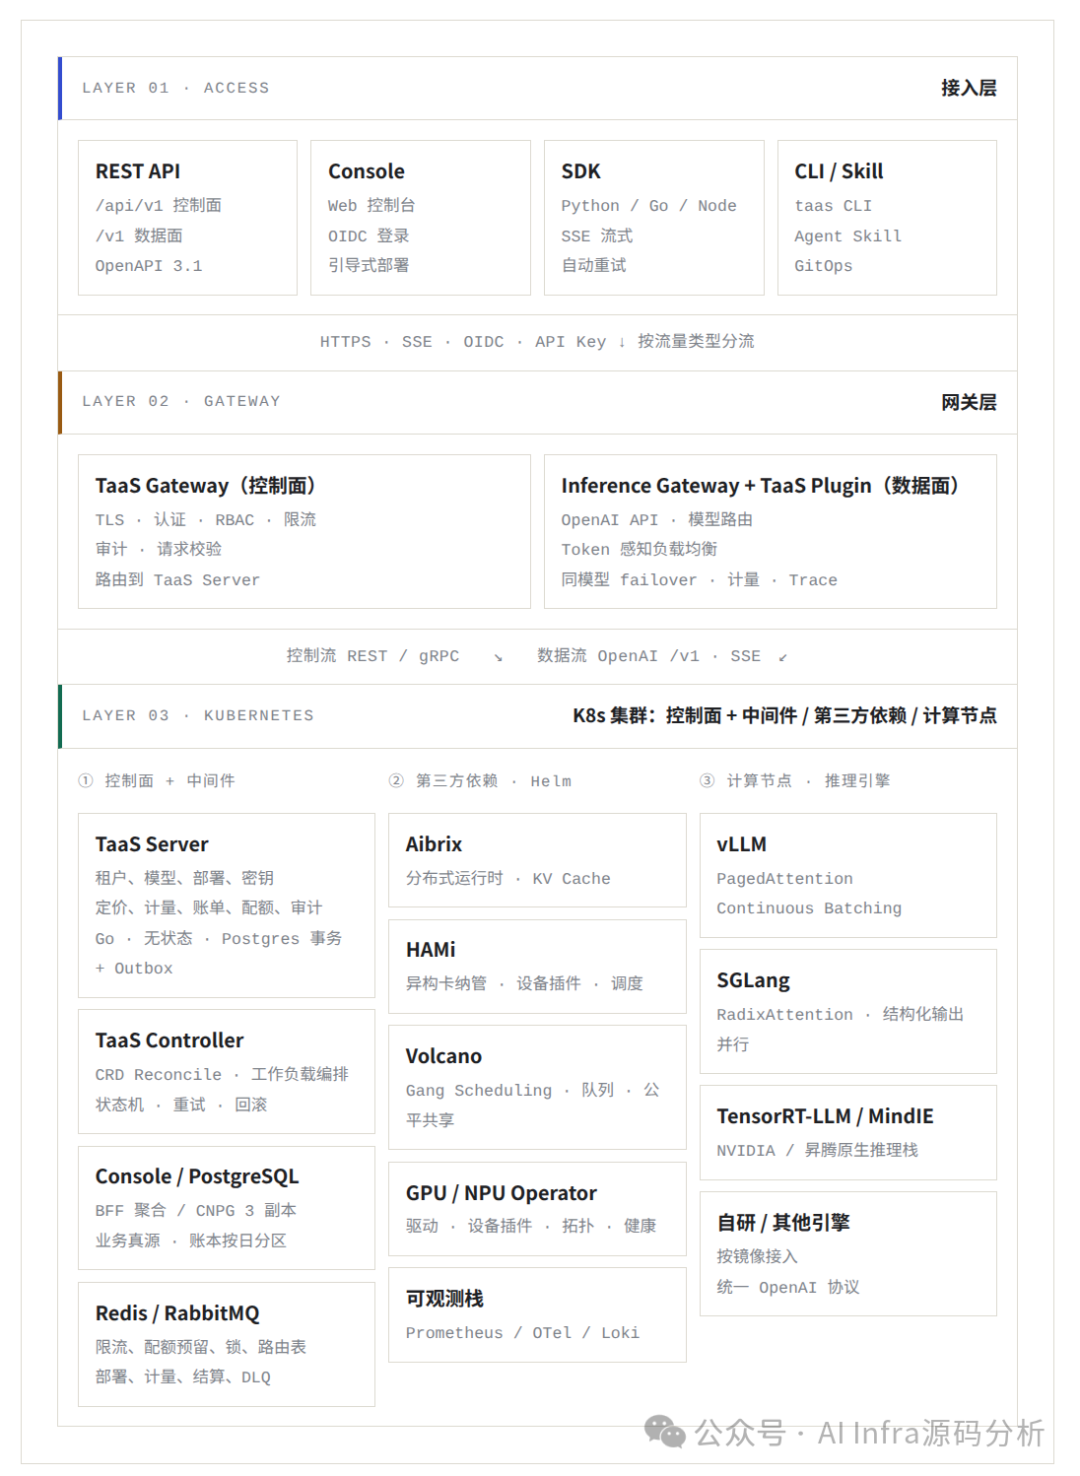
图 2:Go TaaS 三层架构。控制面与数据面分离;K8s 承载全部运行时组件,分控制面、第三方依赖与计算节点三类。
Go TaaS 是三层架构,控制面与数据面分离;K8s 承载全部运行时组件,分控制面、第三方依赖与计算节点三类。
接入层有四种形态,都遵守同一套契约。Console 是给普通用户的,SDK 和 CLI 是给开发者和管理员的,Skill 是给 Agent 的。四者调用相同的遵循 OpenAPI 规范的 RESTful API 接口,避免行为漂移。
网关层做了一个关键拆分:控制面走 TaaS Gateway,数据面走 Inference Gateway 加 TaaS Plugin。第三层是 K8s 集群,内部按性质分三类。第一类是我们要自研和长期维护的控制面与中间件;第二类是以 Helm Chart/Operator 部署的第三方依赖组件,Aibrix 做分布式运行时和推理网关,HAMi 管异构加速卡切分,Volcano 做批处理/Gang 调度;第三类是真正干活的推理引擎,vLLM、SGLang、TensorRT-LLM、MindIE,以及客户自研的引擎。它们统一按镜像接入、统一暴露为 OpenAI 兼容接口,对上层透明。
为什么控制面和数据面必须拆
| 维度 | 控制面 | 数据面 |
|---|---|---|
| 流量 | 低频、可重试、强一致、可审计 | 高频、流式、低延迟、可降级 |
| 职责 | 建模型、改价格、发密钥、看账单 | 鉴权、限流、路由、计量、追踪 |
| 故障影响 | 只影响改配置,已部署模型继续服务 | 整个服务不可用,必须能降级 |
| 可用性目标 | 控制面 API P95 < 300ms | 网关可用性 ≥ 99.95% |
混在一起会出两种事故:一次控制台发布引发推理抖动;一次流量洪峰拖垮管理 API。两者的可用性目标、扩容策略、发布节奏都不一样,所以从第一天就应该拆开,而不是等出问题再拆。
控制面挂了,已经部署的模型还能正常服务,只是不能改配置。数据面挂了,服务就没了,所以它必须能降级:Redis 不可用时用本地令牌桶,队列不可用时先本地缓冲,恢复后补偿上报。
推理网关和插件都做了什么
鉴权、限流、路由、计量都放在 Envoy 的 Wasm 插件里执行,推理流量不穿透业务进程。
| 顺序 | 动作 | 关键实现 |
|---|---|---|
| 01 | Auth 鉴权 | API Key 只存加盐哈希;本地缓存 Key 到租户/作用域,TTL + 主动失效。 |
| 02 | Quota 配额 | 令牌桶限流 + 并发租约;Redis 原子扣减;失败 fail-closed 或按策略降级。 |
| 03 | Route 路由 | RoutingGroup → 健康部署 → 加权/延迟/成本;只允许同模型 failover。 |
| 04 | Meter 计量 | 以引擎返回 usage 为准,网关计数兜底;按 request_id 幂等,异步写入队列。 |
| 05 | Trace 追踪 | 注入 traceparent;记录排队、Prefill、Decode、总耗时;日志脱敏。 |
| 06 | Guard 保护 | 请求体大小、max_tokens、超时、取消传播;异常上游快速摘除。 |
| 07 | Cache 缓存 | 幂等请求结果缓存(可选);前缀缓存亲和;命中不影响计费口径。 |
| 08 | Degrade 降级 | Redis/队列不可用时本地令牌桶 + 本地缓冲;恢复后补偿上报。 |
有两个设计取舍值得说。第一,计量失败不能阻断推理。听起来是妥协,其实是必然:如果计量组件故障就拒绝服务,故障半径会从账单不准扩大到业务全停。正确做法是先放行、进补偿队列、按 request_id 对账,事后把差异归因。第二,用 Wasm 而不是自己写 sidecar。Wasm 插件可以独立发布、灰度、回滚,不随 Server 发版;它跑在 Envoy 进程内,不增加一次网络跳转。P99 敏感的场景,一次跳转就是几十毫秒。
如何准确地计量
计量是 TaaS 平台最重要的部分之一。计量不准,后面的定价、配额、账单、毛利全是错的。客户可以接受贵,不能接受算不清。
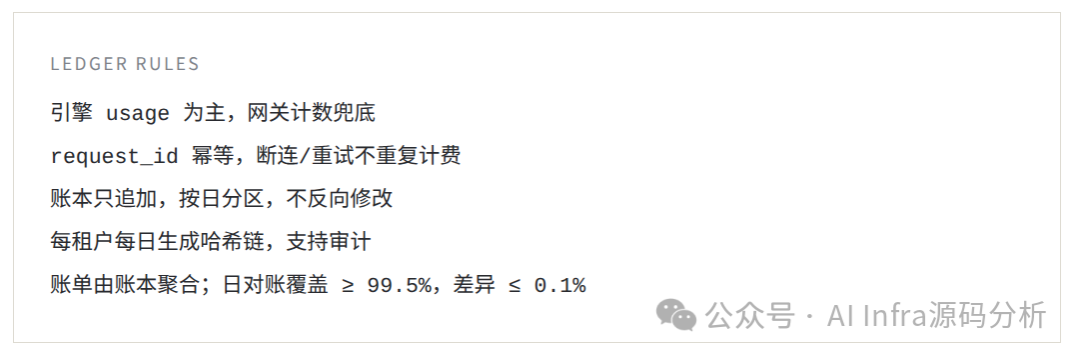
难点不在数 Token,在口径。网关自己做 tokenizer,会受 chat template、工具调用格式、多模态输入的影响,和引擎实际计算的长度不完全一致。所以必须以引擎返回的 usage 为主,网关计数做兜底,并且按日对账。计量还要区分 prompt、completion、cached、reasoning 四类 Token,因为它们的成本结构不同,定价也应该不同。
流式请求中途断开,是最典型的边界情况。引擎可能已经算了 Token,网关可能没收到完整响应;如果重试,又可能重复计费。解决办法不复杂,但必须一开始就设计:每个请求分配 request_id,计量事件按 request_id 幂等;账本只追加、不修改;余额由聚合任务计算,聚合本身也要幂等。
这套规则听起来像财务要求,其实是产品要求。客户拿到账单,要能按 request_id 下钻到每一次调用;出现差异,要能 100% 归因。做不到这两点,SLA 就是一句空话。
管理视图和用户视图的典型流程对比
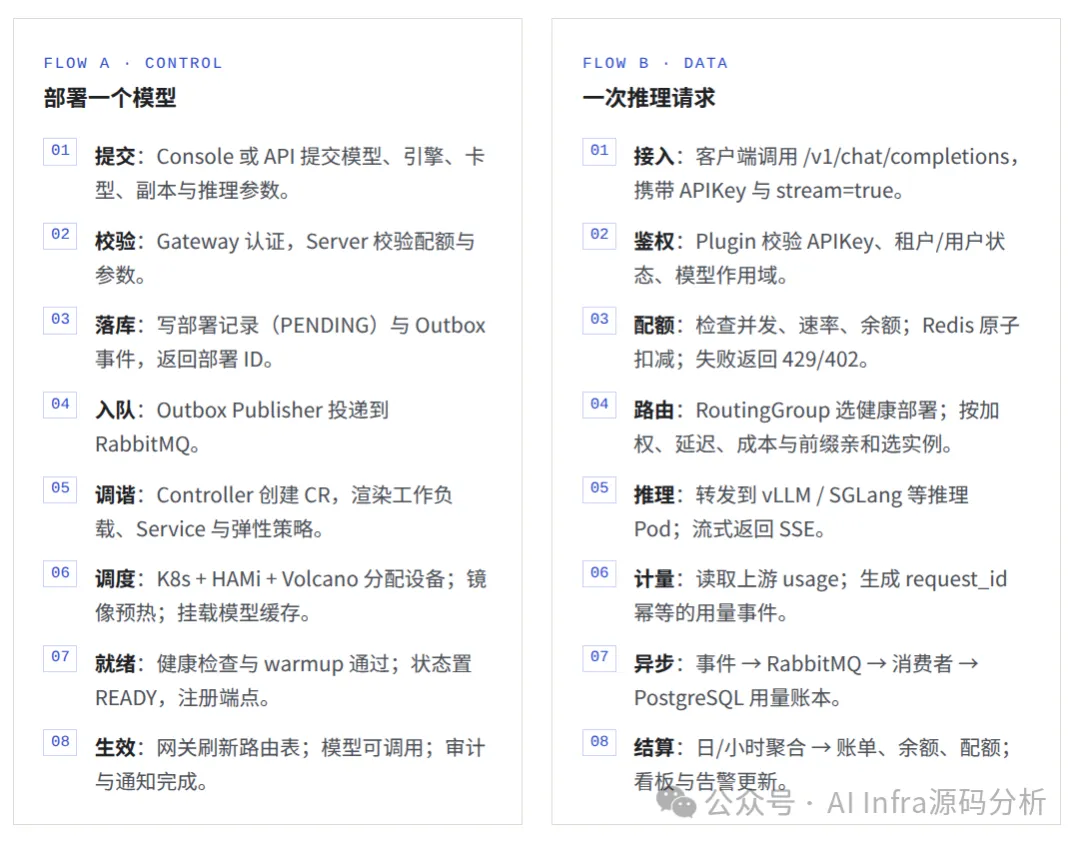
部署链路是异步的,每一步都可能失败,所以需要状态机、重试和回滚。Controller 的作用是不断把实际状态拉向期望状态,而不是执行一次命令就结束。推理链路是同步的,而且必须快;第 6 步之后全部异步,计量和结算不阻塞响应。
第 8 步强调日/小时聚合,原因是账单不能每次请求都去更新余额,那样数据库扛不住。账本只追加,余额由聚合任务算,聚合要幂等。
设计决策
- CRD 是期望状态的唯一来源。 Server 写 CR,不直接写 Deployment;Controller 调谐,支持漂移检测。
- Outbox + 幂等消费。 业务事务与消息投递解耦;按 request_id / deployment_id 幂等,避免重复扣费。
- 计量以引擎 usage 为准。 网关 tokenizer 受 chat template 影响;引擎 usage 为主、网关计数兜底,按日对账。
- 热路径不写数据库。 网关只读写本地缓存与队列;Postgres 只由 Server 和异步消费者写入。
- 第一天就支持多集群。 P0 可以只部署一个集群,但数据模型里必须有 cluster_id 与 placement_policy。
- 单元化(Cell)架构。 每个 Cell 约 100–500 卡,自带网关、Controller、Redis;单 Cell 故障不扩散。
- API-first,SDK 生成。 OpenAPI 是契约,SDK、CLI、Console 共用一套接口,避免行为漂移。
- 选择无聊的技术。 Go + Postgres + Redis + RabbitMQ + K8s;创新留给推理优化与验证矩阵。
第 4 条不是性能优化,是可用性设计。推理峰值可能是管理流量的几万倍,网关直接写库,一次促销就能把平台打死。第 5 条也不是第一天就部署多集群,而是字段要留好。否则到 P1 再改表、改 API、改权限,成本极高,而且一定会漏。
第 6 条值得展开。单元化是为了控制爆炸半径。一个 Cell 出问题,不能把全国租户一起带走。每个 Cell 自带网关、Controller 和 Redis,跨 Cell 只保留必要的全局调度与计费汇总。代价是运维复杂度上升,收益是故障隔离和容量弹性。
容量与 SLO
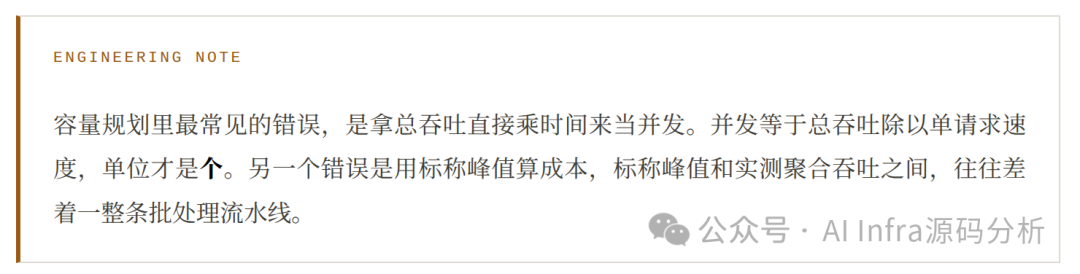
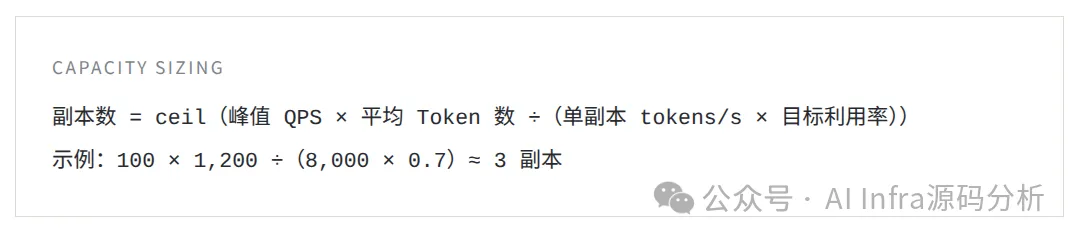
公式很简单,但有两个坑。单副本吞吐必须实测,不能用标称峰值;平均 Token 数要按业务分布算,不能只看平均值,长尾请求会显著拉高驻留时间。
| 指标 | 建议值 | 说明 |
|---|---|---|
| 网关可用性 | ≥ 99.95% | 数据面是所有流量的入口,目标应高于推理本身 |
| 推理可用性 | ≥ 99.9% | 按模型、卡型分别统计,不混算 |
| TTFT P95 | < 1.5s | 7B 模型、1K prompt 的基线,需按实际校准 |
| TPOT P95 | < 50ms | 每 Token 延迟,直接决定流式体验 |
| 计量准确率 | ≥ 99.5% | 与引擎 usage 对账,差异需归因 |
| 控制面 API P95 | < 300ms | 不包含异步部署耗时 |
SLO 为建议值,必须按实际基线校准。SLA 应与模型、卡型、上下文长度、并发绑定,对外给出基线 + 降级策略,而不是单一数字。
同样叫可用性 99.9%,7B 模型 1K 上下文和 70B 模型 128K 上下文完全是两件事。SLA 如果不绑定这些条件,签的时候容易,赔的时候一定吵架。
05 / Community:Go TaaS 的代码与治理
前面四节讲的是判断和设计,这一节讲代码在哪、长什么样、怎么参与。
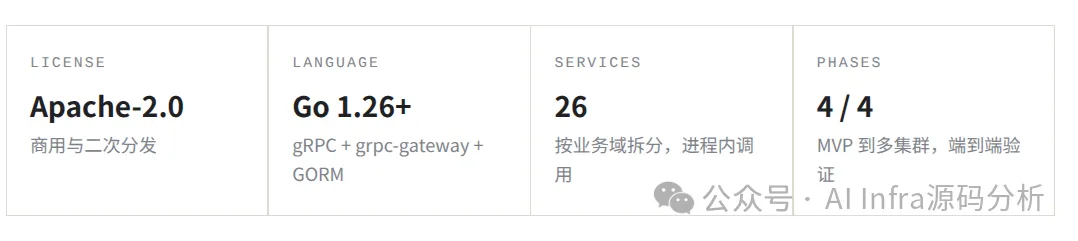
仓库是 github.com/go-taas/go-taas,Apache-2.0 License,主语言 Go。项目在 2026 年 8 月建立,到 10 月 AI 已经把规划中的四个阶段全部落地,单元测试、FVT 功能验证和基于 Docker Compose / Helm 的端到端套件都在跑。这不是一个只有架构图的仓库,但也不是一个可以生产落地的项目。AI 有没有按照架构来跑需要大家来一起验证。
仓库结构:按职责边界划分
仓库没有按技术层分目录,而是按职责边界分。读代码时,先看这张表就够定位大部分问题。
| 路径 | 内容 | 说明 |
|---|---|---|
services/ | 26 个业务服务目录 | auth、tenancy、account、model、image、infer、runtime、routing、provider、metering、billing、batch、audit、webhook、notification、observability、tracing、resourcemetrics、accelerator、cluster、optimization、prompt、evaluation、fault、vgpu、docs |
apps/ | 可执行入口 | taas-server 与 taas-controller 两个二进制 |
internal/controller | Kubernetes Operator | CRD 调谐、工作负载编排、状态机与回滚 |
pkg/ | 共享基础库 | config、database、grpcmiddleware、k8s、mq、redisx、registry、modelhub、logger、errors、server、nano |
proto/ | 接口契约 | Protobuf 定义,buf 生成 gRPC stub、HTTP 网关与 OpenAPI |
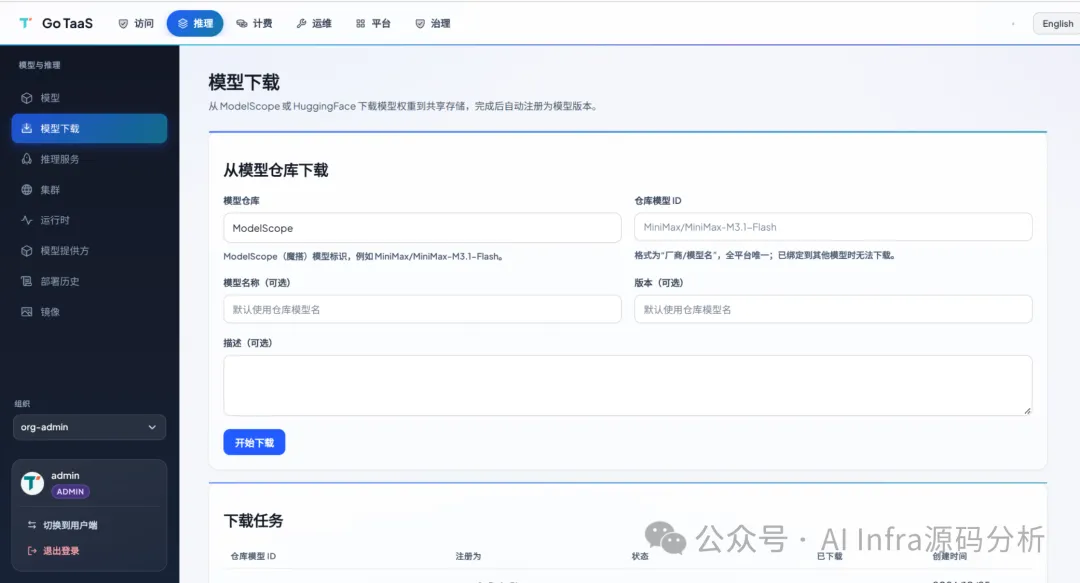
web/ | 前端 SPA | React 18 + TypeScript + Vite,同一份构建同时服务用户控制台与管理员控制台 |
deploy/ | 部署 | helm/go-taas 生产 chart;compose 本地开发测试 |
site/ | 文档站 | 中英双语的架构与设计文档,每个功能点一份 |
test/ | 测试 | fvt 功能验证套件;e2e 浏览器端到端套件 |
有一个细节值得单独说:所有 26 个服务跑在同一个 Deployment 里,服务之间是进程内调用。这不是偷懒,而是早期阶段刻意避免分布式复杂度。真正的异步边界只有一处:业务事务通过消息队列交给 Controller,再由 Controller 去调谐 Kubernetes 资源。API 的响应速度和集群的收敛速度因此解耦,部署失败也不会把请求线程一起拖住。
技术栈
| 层 | 选型 |
|---|---|
| 后端 | Go、gRPC + grpc-gateway、GORM |
| 数据 | PostgreSQL、Redis(兼容 Valkey)、Kafka 或 RabbitMQ |
| 控制面网关 | grpc-gateway,HTTP/JSON 与 OpenAPI 由 Protobuf 生成 |
| 数据面网关 | Envoy + Wasm 插件 |
| 存储 | Longhorn 存集群状态;MinIO + JuiceFS 存权重与镜像 |
| 网络 | CNI + ClusterIP Service + CoreDNS;Envoy Gateway 负责南北向 TLS 终结;NetworkPolicy 隔离;推理面可选 RDMA(RoCE / InfiniBand) |
| 编排 | Kubernetes + client-go |
| 推理引擎 | vLLM / SGLang / TensorRT-LLM 等,按镜像接入 |
| 前端 | React 18 + TypeScript + Vite |
| 测试 | Go 单测 + FVT + Nightwatch 浏览器端到端 |
快速上手
本地体验用 Compose,生产部署用 Helm。两条路都写在 README 里,不需要额外文档。前提是部署好你自己的 K8s 集群(存储、网络、GPU Operator)等。
1 | # 本地一键栈:控制面 + PostgreSQL + Redis + MQ + JuiceFS 客户端 |
Compose 栈会自动准备 MinIO bucket、JuiceFS 文件系统、taas 命名空间、模型权重的 StorageClass 与 PVC,以及加速卡节点标签。这一步省掉的是最容易劝退新人的环境准备,而不是把复杂度藏起来——Helm chart 里同样是内嵌的 PostgreSQL、Redis、RabbitMQ,每一项都可以换成外部实例。
调用方式和 OpenAI 完全一致,换一个 base_url 就能把现有代码接过来:
1 | from openai import OpenAI |
社区的运作方式
Go TaaS 采用公开治理,规则写在仓库里,四份文档构成完整的协作契约。
| 文档 | 回答的问题 |
|---|---|
GOVERNANCE.md | 角色、权限、晋升路径与决策机制:谁能合并、争议怎么裁决、版本怎么发布。 |
MAINTAINERS.md | 当前维护者、各自负责的领域、review 的响应时间承诺。 |
CONTRIBUTING.md | 开发环境、提交规范、PR 要求,以及从贡献者到维护者的成长阶梯;非代码贡献同样计入。 |
GITHUB-TEAMS.md | 组织团队、权限映射、CODEOWNERS 与分支规则集的具体配置。 |
工程约定偏严格,但都是自动化的:提交遵循 Conventional Commits,由 commitlint 校验;PR 合并前要过 make lint 和 make ut;接口变更先改 proto/,再 make pbgen 生成代码,不允许手改生成物;发布走语义化版本,changelog 自动生成。这些规则对第一次提交的人不太友好,但对第五百次提交的人是保护。
参与方式
项目刚刚开始,欢迎技术大佬们一起来维护这个项目。
最容易上手的是标了 good first issue 的条目,以及在 Discussions 里描述你遇到的具体环境。附上卡型、驱动版本、引擎版本和复现步骤的 issue,处理速度会比一句跑不起来快一个数量级。
Join the community
Go TaaS 是一个开源项目,代码、文档、治理规则都在同一个仓库里。你可以先把它跑起来,再决定要不要留下。
- 如果你手里有算力,正在发愁怎么把异构、碎片、闲置的资源变成可计量的 Token,这里有一套现成的部署、调度、计量、账单。
- 如果你是系统集成商,需要一个可私有化、可交付的底座,Helm chart 已经写好,欢迎拿真实项目来压。
- 如果你是推理引擎、运行时、K8s 或 SRE 工程师,想把 vLLM、SGLang、Aibrix、HAMi、Volcano 在某种卡上再快一点,这里有一堆没解决的 issue。
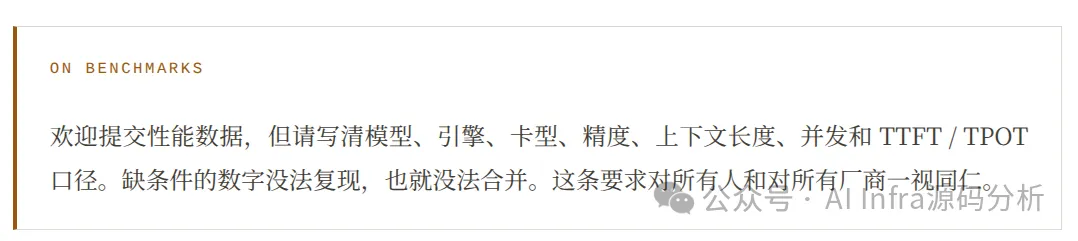
三类贡献最受欢迎:可复现的 benchmark,写清模型、引擎、卡型、精度、上下文和并发;卡型与模型的适配模板,让别人少踩一遍你踩过的坑;部署 recipe 与文档,把我跑通了变成任何人都能跑通。
社区的技术原则不复杂:不静默换模型;降级要显式;计量可审计,账单可下钻;先闭环,再扩张。
GitHub: go-taas/go-taas
Issues 报缺陷,Discussions 提问与讨论,CONTRIBUTING 里有开发环境与提交规范。第一个 PR 不必很大,修一个错别字也算。
 微信
- 支付宝