如何利用 AIBrix 实现 Token 工厂的推理服务
把 vLLM 跑起来只要一行命令,但把它变成 Token 工厂里可售卖的一个推理服务,问题会立刻变多:
一个推理服务要跨 4 台机器、每台机器8 张卡,用什么 K8s 自定义资源描述这种布局?prefill 和 decode 分开部署时,两个角色怎么配对、怎么分别调参?网关是怎么知道 qwen3.8-27b 这个模型现在在哪几个 Pod 上运行,而不是每个请求都查一次数据库?自动扩缩容该看哪些指标,为什么不是 CPU 和 内存?
Go TaaS 是利用 AIBrix 来解决这些问题的:AIBrix 负责“把模型跑起来、把请求送到正确的 Pod、按负载调整副本”,Go TaaS 负责“谁能用、用多少、怎么计费”。
下面按这条边界拆开讲。相关的设计文档在Go TaaS 官网,代码在 GitHub,感兴趣的读者可以详细阅读。
一、AIBrix 管推理服务编排,Go TaaS 管账
Token 工厂的控制面并不需要知道某个 Pod 的 IP。它需要知道的是:这个模型有没有可用的副本、这次调用是谁花的钱、这把 Key 能不能调这个模型。前者是编排,后者是管账。Aibrix和Go TaaS的能力边界定义见下表:
| 能力 | AIBrix | Go TaaS |
|---|---|---|
| 推理服务自定义资源 | 定义StormService、PodAutoscaler等 CRD | 创建这些自定义资源 |
| 推理 Pod 创建及调度 | 由 AIBrix 控制器创建 | 选择调度器、优先级、卡型、镜像与权重卷、推理参数、环境变量等 |
| LLM请求到 Pod 的转发 | ext_proc 网关按 Pod 元数据与 HTTPRoute 选后端 | 保证标签、路由与授权等k8s资源存在 |
| 自动扩缩容 | PodAutoscaler 按引擎指标调整 stormservice 副本 | 提供策略与上下限等配置 |
| 鉴权、限流、截断 | - | 数据面 Gateway 上的 Wasm 插件 |
| 计量与计费 | - | 从推理引擎响应的 usage 取数、入账、结算 |
| 运行时健康 | 采集到Prometheus | 展示 |
这条边界是基于系统的可维护性所做的权衡。数据面(Aibrix)每多一次控制面调用,就多一个故障点;反过来,控制面(Go TaaS)每多托管一份推理状态,就多一次一致性维护。
推理请求的完整路径如下图所示:
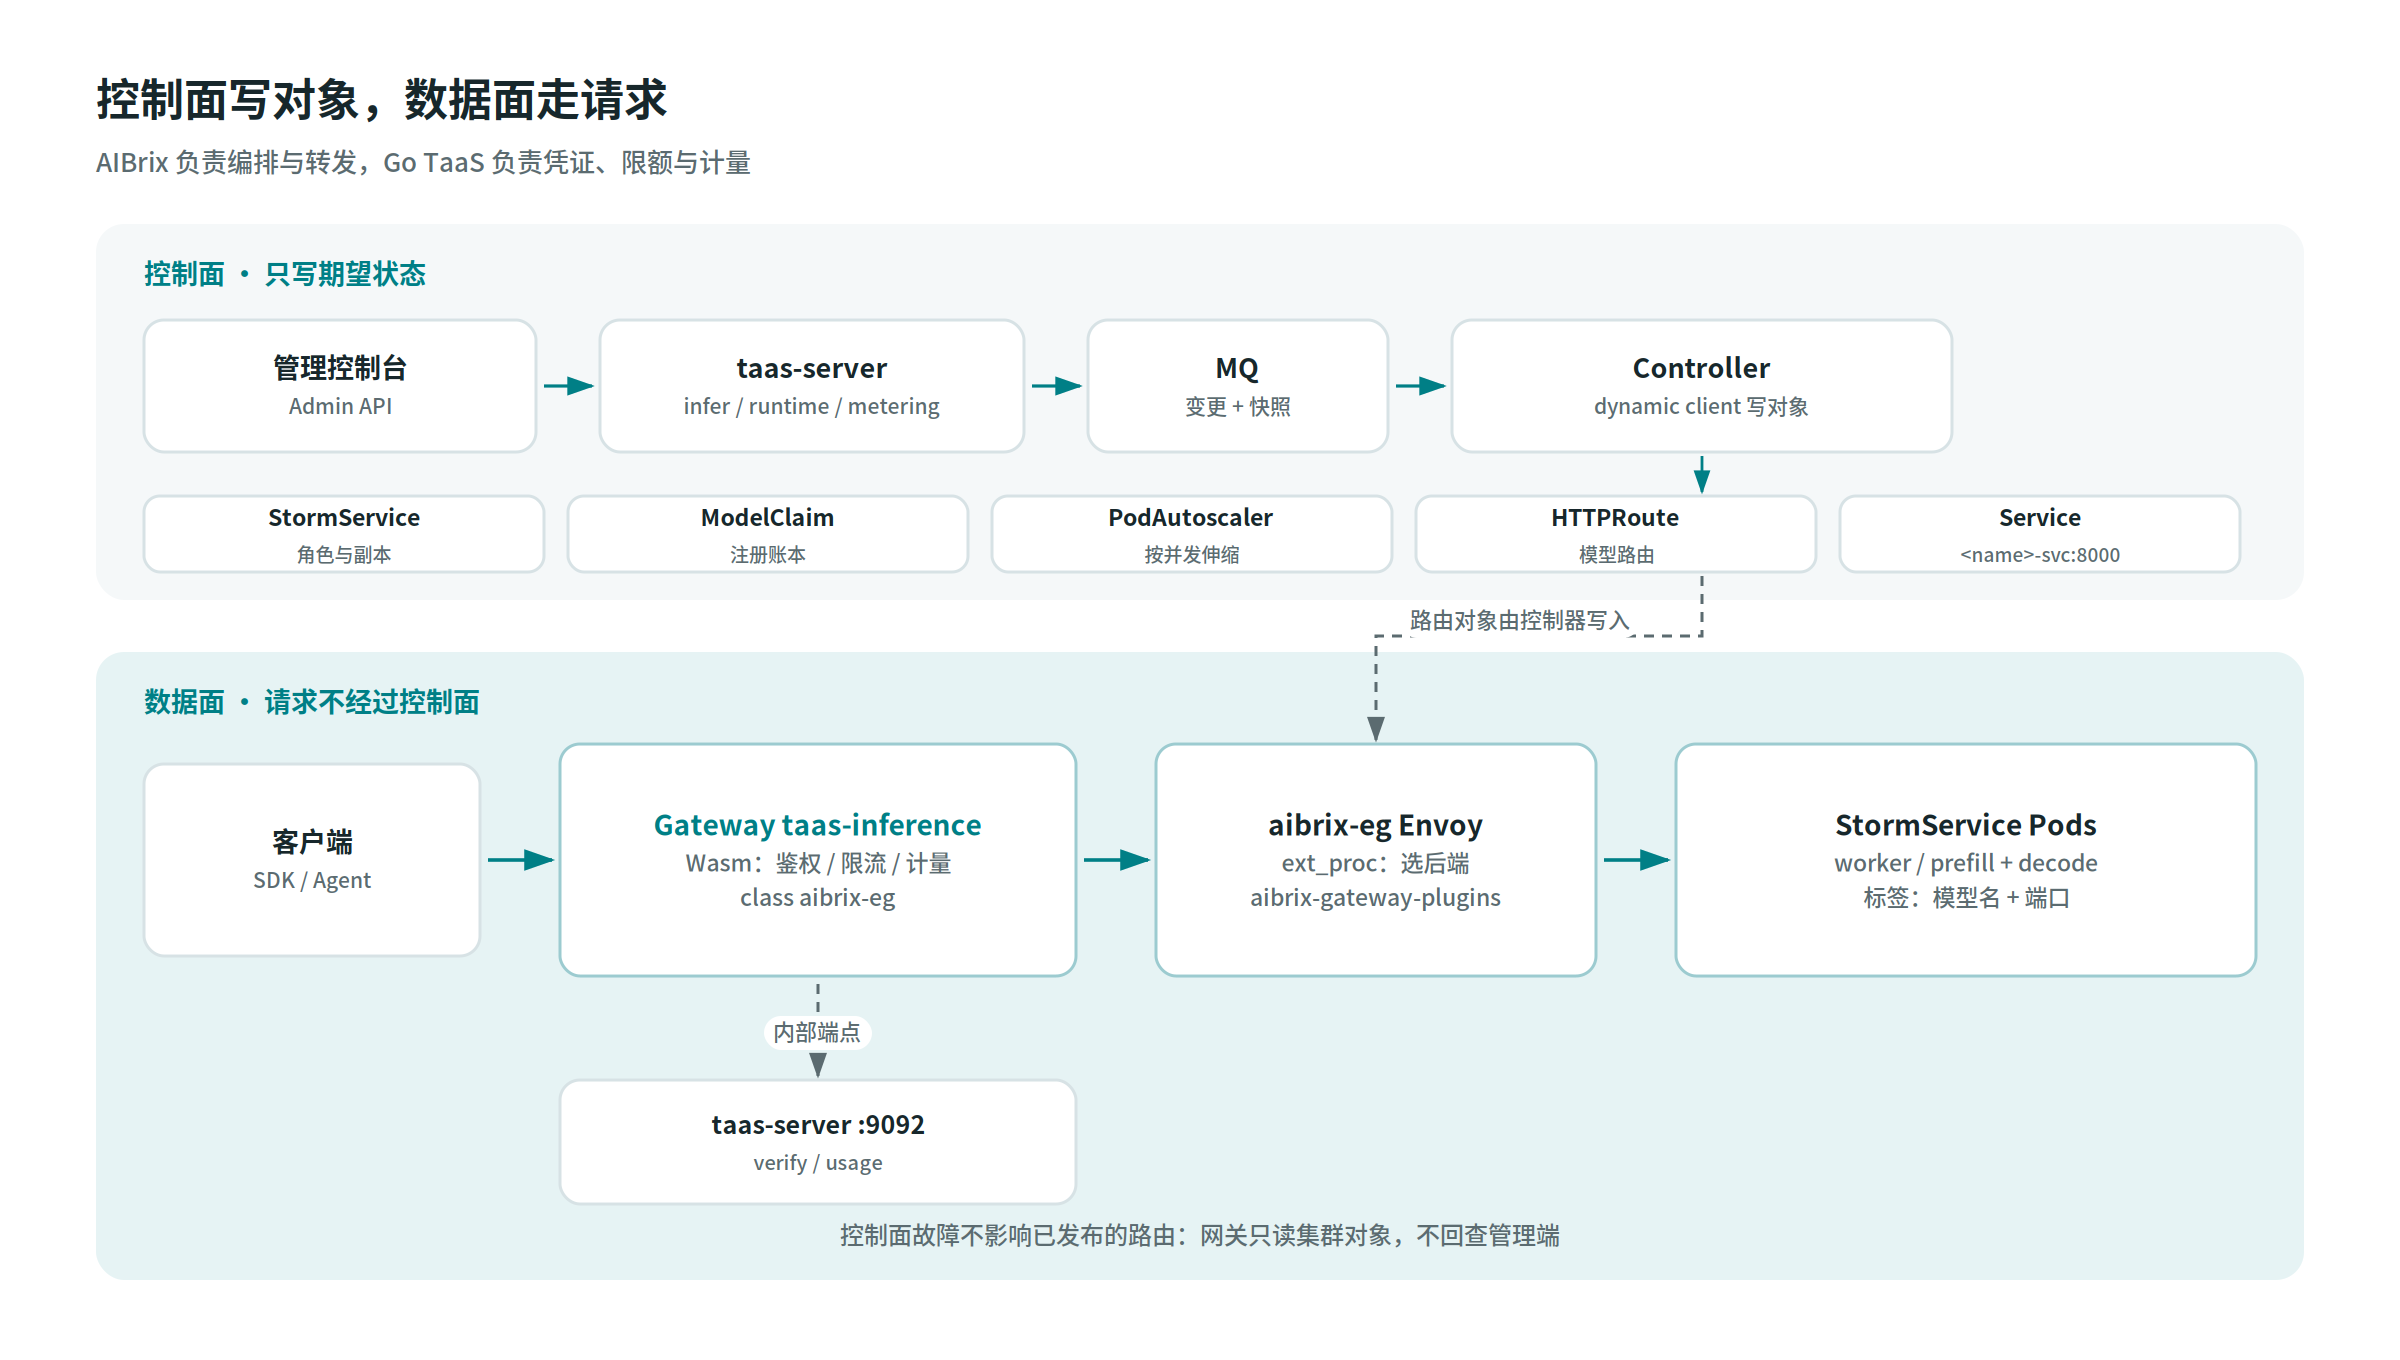
客户端推理请求先到 Go TaaS 自己的数据面 Gateway(taas-inference,class 为 aibrix-eg)。Wasm 插件校验 API Key、执行 Key 级限速与单请求输出上限,然后在响应尾部读取引擎返回的 usage 并上报计量。之后才进入 AIBrix 的 Envoy(envoy-aibrix-system-aibrix-eg),由 aibrix-gateway-plugins 以 ext_proc 的形式选择后端 Pod。
这两个反向代理不是重复实现。第一个是 Go TaaS 自己的 Envoy,策略、证书、生命周期都归 TaaS 平台;第二个属于 AIBrix 的网关(OpenAI 兼容)。把鉴权放在第一个,未授权的请求在到达第二个代理之前就被拒掉;把路由留在第二个,是因为只有它知道模型与 Pod 的对应关系。
逐请求选哪个 Pod,是 AIBrix gateway plugins 的事:最少请求、前缀缓存亲和性路由之类的策略在 ext_proc 里执行。Go TaaS 不参与这个选择,也不把租户信息带进这一层;它只保证网关能看到正确的模型与后端 Service。要换路由策略,改 AIBrix 的配置,不动平台代码。这也是把路由留在 AIBrix 的实际收益:策略可以独立演进,平台的权限与计费链路不受影响。
还有一个默认关闭的可选配置:model-router。开启后它只处理到 /v1/chat/completions的路由,把第三方 provider 提供的模型服务转给控制面的代理,其余请求原样转给 AIBrix。鉴权、限流、计量仍然在它之前的网关上,所以它只做上游选择,不改变权限链路。
反过来说,控制面(taas-server)不代理推理流量:它只在网关插件的两次内部调用里出现——校验 Key、上报用量;其余时间只把变更通过消息队列交给控制器,控制器再创建 Kubernetes 自定义资源。控制面重启、数据库慢查询、管理页打不开,都不会让已经发布的路由失效。
二、单机/多机/PD分离推理都走StormService
生产路径中,Go TaaS 控制器拿到 Kubernetes dynamic client 后,每个推理服务都对应一个 AIBrix StormService(orchestration.aibrix.ai/v1alpha1),单机、多机和 PD 的差异都写进它的 roles。只有没有 dynamic client 的兼容路径(例如单元测试)才创建普通 Deployment。
StormService 把服务副本数、角色和每个角色的 Pod 组写在一个对象里。配置 Volcano 调度器时,控制器还会创建 PodGroup 并将 Pod 加入组,以启用 Gang 调度;但 Gang 并不是默认保证。没有配置 Volcano 时,Pod 仍由集群默认调度器逐个调度。
相比普通 Deployment,StormService 还可以在同一服务下描述不同角色。PD 分离会生成 prefill 和 decode 两个角色,各自有 Pod 组和角色副本数;Deployment 的“N 个相同 Pod”无法直接表达这种差异。
扩缩容也对应 StormService:控制器使用 AIBrix PodAutoscaler,不创建 HPA;spec.replicas 是服务副本数,不是 Pod 数。
一个单机服务的 StormService 大致是这样:
1 | apiVersion: v1 |
spec.replicas 是服务副本数。每个角色再用 replicas 表示该角色的 Pod 组数,用 podGroupSize 表示每组 Pod 数。单机与多机使用 worker 角色,PD 使用 prefill、decode 两个角色:
| 拓扑 | 每个服务副本的 Pod 数 | 形态 |
|---|---|---|
single | 1 | 单个 worker Pod;Pod 内使用 TP × PP 张卡 |
multinode | TP × PP / gpu_per_pod | 一个 worker 角色;每 Pod 使用 gpu_per_pod 张卡 |
pd | (prefill_replicas + decode_replicas) × TP × PP / gpu_per_pod | prefill、decode 各自使用相同大小的 Pod 组 |
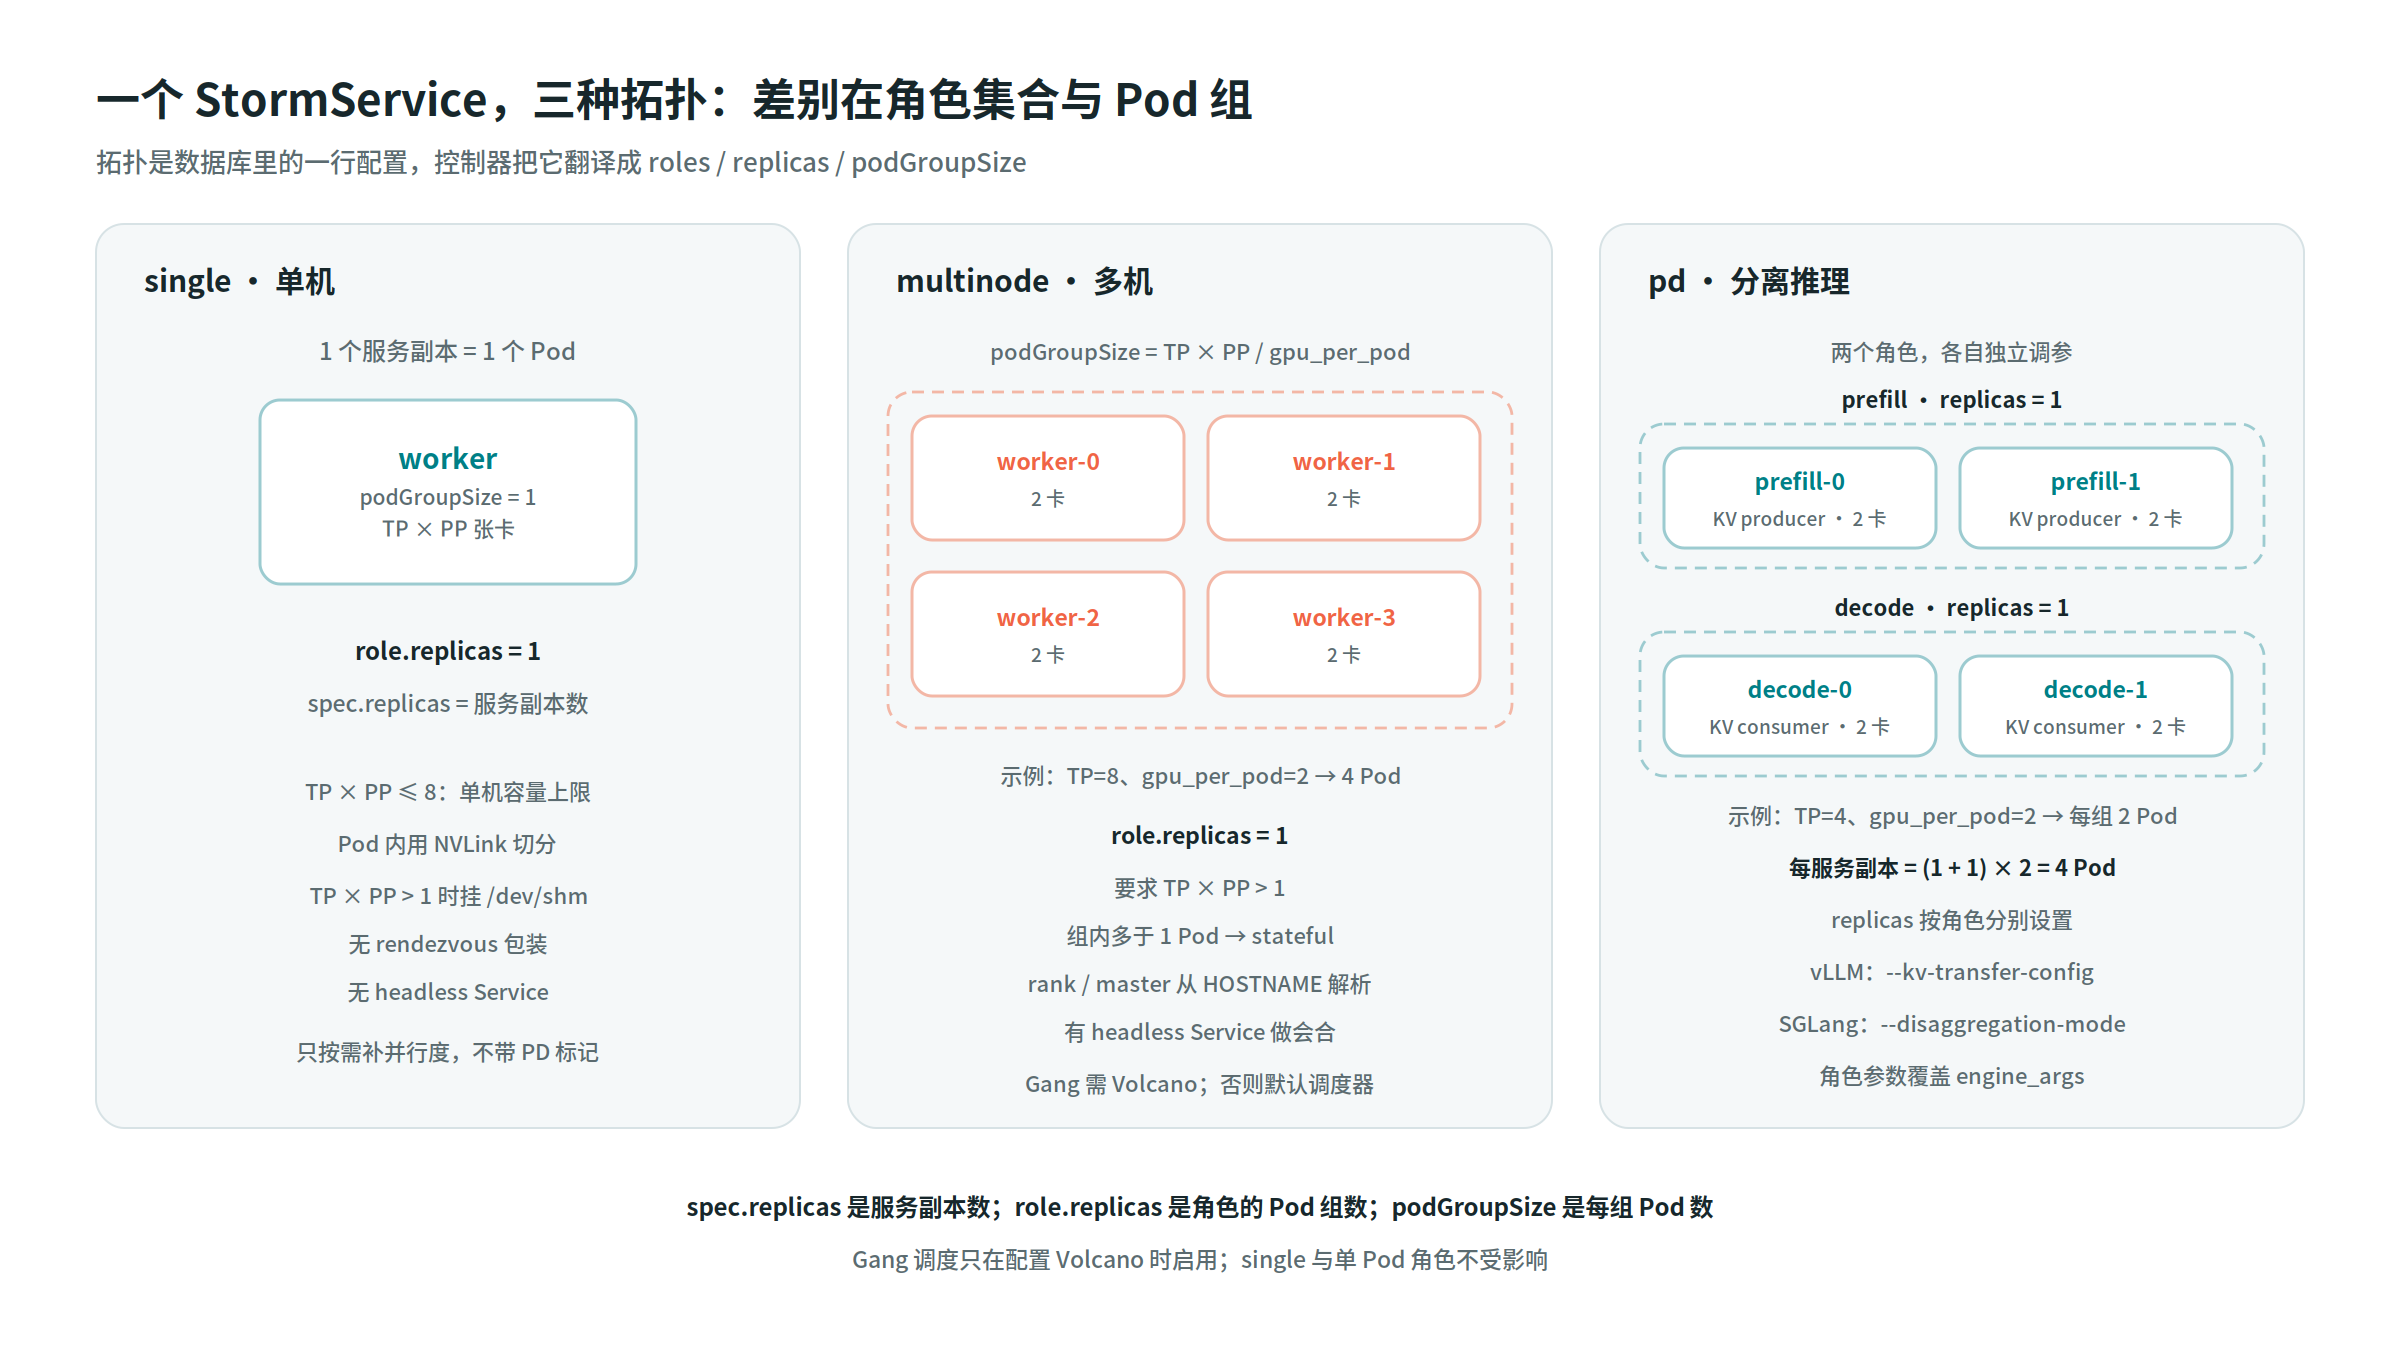
公式里的 Pod 数是每个服务副本所需的数量,整个服务还要乘以 spec.replicas。TP 和 PP 默认为 1;并行度各自须在 1 到 100 之间,乘积最多 100。single 的乘积还不能超过单 Pod 上限 8,卡数由 TP × PP 推导;multinode 必须满足 TP × PP > 1,其与 pd 的 gpu_per_pod 默认为 1、范围为 1 到 8,须能整除 TP × PP,且不能大于总卡数。无效组合会在写入前返回 10319 INFER_TOPOLOGY_INVALID。PD 只接受 vLLM 或 SGLang,引擎角色副本数默认为 1、范围为 1 到 100。
因此 gpu_per_pod 会改变 Pod 组大小;当它等于 TP × PP 时,multinode 或 pd 每个角色的 Pod 组也只有 1 个 Pod,不会启用跨 Pod rendezvous。
把数字代进去:
| 场景 | 参数 | 一个副本的 Pod 数 |
|---|---|---|
| TP=8、PP=1,每 Pod 1 卡 | multinode,gpu_per_pod=1 | 8 |
| TP=8、PP=1,每 Pod 2 卡 | multinode,gpu_per_pod=2 | 4 |
| PD,2 个服务副本,每副本 1 prefill + 2 decode,单卡 | pd,TP=8,PP=1,gpu_per_pod=1 | (1 + 2) × 8 = 24,两个副本共 48 |
这里算出的是 Pod 数,不代表调度器一定会把每个 Pod 放到不同物理机器;实际放置取决于集群调度配置。
多 Pod 角色:rank 在容器启动时才确定
当某个角色的 podGroupSize 大于 1 时,控制器将 StormService 标记为 stateful。AIBrix 为 storm 创建 headless Service,为 Pod 提供稳定主机名;同一角色的 Pod 共用模板,在容器启动时根据主机名解析 rank,并以该角色的 Pod 组大小设置 --nnodes:
1 | rank="${HOSTNAME##*-}" |
示例里的 4 代表该角色的 podGroupSize,实际值由控制器写入命令。vLLM 使用 --master-addr / --master-port,SGLang 使用 --dist-init-addr。脚本只在多 Pod 角色上启用;引擎参数作为 shell 位置参数传递,避免 kv-transfer-config 等 JSON 值被二次解析。
并行推理还需要足够的 /dev/shm:当服务是多机/PD 拓扑,或 TP × PP > 1(包括单机多卡)时,控制器给 Pod 挂载 2 GiB 的内存型 emptyDir。否则 Kubernetes 默认的共享内存空间可能不足以启动引擎。
PD分离
PD 分离的 storm 有两个角色,各自带副本数与 Pod 组。控制器只补引擎自己推导不出来的参数:
- vLLM:prefill 用
--kv-transfer-config的kv_producer,decode 用kv_consumer,默认连接器是PyNcclConnector; - SGLang:prefill 用
--disaggregation-mode prefill,decode 用decode; - 并行度大于 1 时,补
--tensor-parallel-size/--pipeline-parallel-size(SGLang 是--tp-size/--pp-size);PD 角色还补各自的 Prefill/Decode 标记。
角色级参数覆盖共享参数:engine_args 是两边共享的,role_engine_args 按角色覆盖,角色的额外参数追加在共享参数之后。因此 prefill 可以单独调显存比例,decode 可以单独调最大并发,不必把一个角色的调优复制给另一个。用户显式给出的 flag 永远优先,包括自己提供的 kv-transfer-config。
就绪判定跟随引擎
控制器监听该服务的 Pod:最新 Pod 被调度到节点后状态进入 starting;如果任一 Pod 出现无法恢复的启动错误(例如 ImagePullBackOff、CreateContainerError、OOMKilled),部署立即失败。控制器轮询服务的 Pod,任意一个能回答 /health 或 /health_generate,服务就记为 running。这适用于多 Pod/PD 中只由某些 Pod 暴露 API 的情况;始终没有 Pod 健康响应时,等待超时后报告失败。
只所以做这样的设计,是因为Pod 处于 Running 状态只说明进程启动了,权重可能还在加载;只有引擎自己回答了健康检查,才说明它能生成 token,整个推理服务才能进入运行中的状态。
原地更新
拓扑可以通过 :update-topology 接口原地修改:控制器把服务置回 pending,以新的角色集合更新 StormService。服务 ID 和访问地址不变,StormService 使用 RollingUpdate,maxUnavailable 固定为 1。
配置 Volcano 调度器时,控制器会创建 PodGroup 并将 Pod 模板关联到该组;没有配置 Volcano 时不写 PodGroup,Pod 由集群默认调度器逐个放置。因此只有 Volcano 路径提供 Gang 调度,不能把这种原子放置视作所有集群上的默认行为。
三、模型怎么被网关找到
服务跑起来之后,还需要一条路由把请求送到这些 Pod。
这里有一个容易想当然的地方:AIBrix 的 StormService 只负责把 Pod 跑起来,它不会为服务创建 HTTPRoute。 storm 的 role 模板里只有模型元数据;把“模型名 → Service → Pod”这条链路补全,是 Go TaaS 控制器在每次 upsert 时做的(applyModelRoute):
| 对象 | 位置 | 作用 |
|---|---|---|
| Pod 标签与注解 | 推理 Pod(storm 的 role 模板) | 告诉网关这个 Pod 服务哪个模型、监听哪个端口 |
Service <name>-svc | 推理服务命名空间 | 选中该服务的 Pod,暴露 80 与 8000 两个端口 |
HTTPRoute <model>-router | AIBrix 网关命名空间 | 把带 model: <名称> 请求头的流量绑到后端 Service |
ReferenceGrant | 推理服务命名空间 | 允许网关命名空间的 HTTPRoute 引用本命名空间的 Service |
后三个对象都由控制器写:先写 ReferenceGrant(名字是 <网关命名空间>-reserved-referencegrant-in-<推理命名空间>),再写 HTTPRoute,两者都按名 create-or-update。网关命名空间与 Gateway 名默认是 aibrix-system / aibrix-eg,可以配置成别的。
顺带一提,aibrix 方案下控制器也会写 ModelClaim,但它不在这条路径上:AIBrix 的放置控制器只把热池里的 Pod 当作候选,普通引擎 Pod 的 claim 会停在 Pending,所以路由不能指望它。plain 方案只影响是否写 ModelClaim,路由照写。
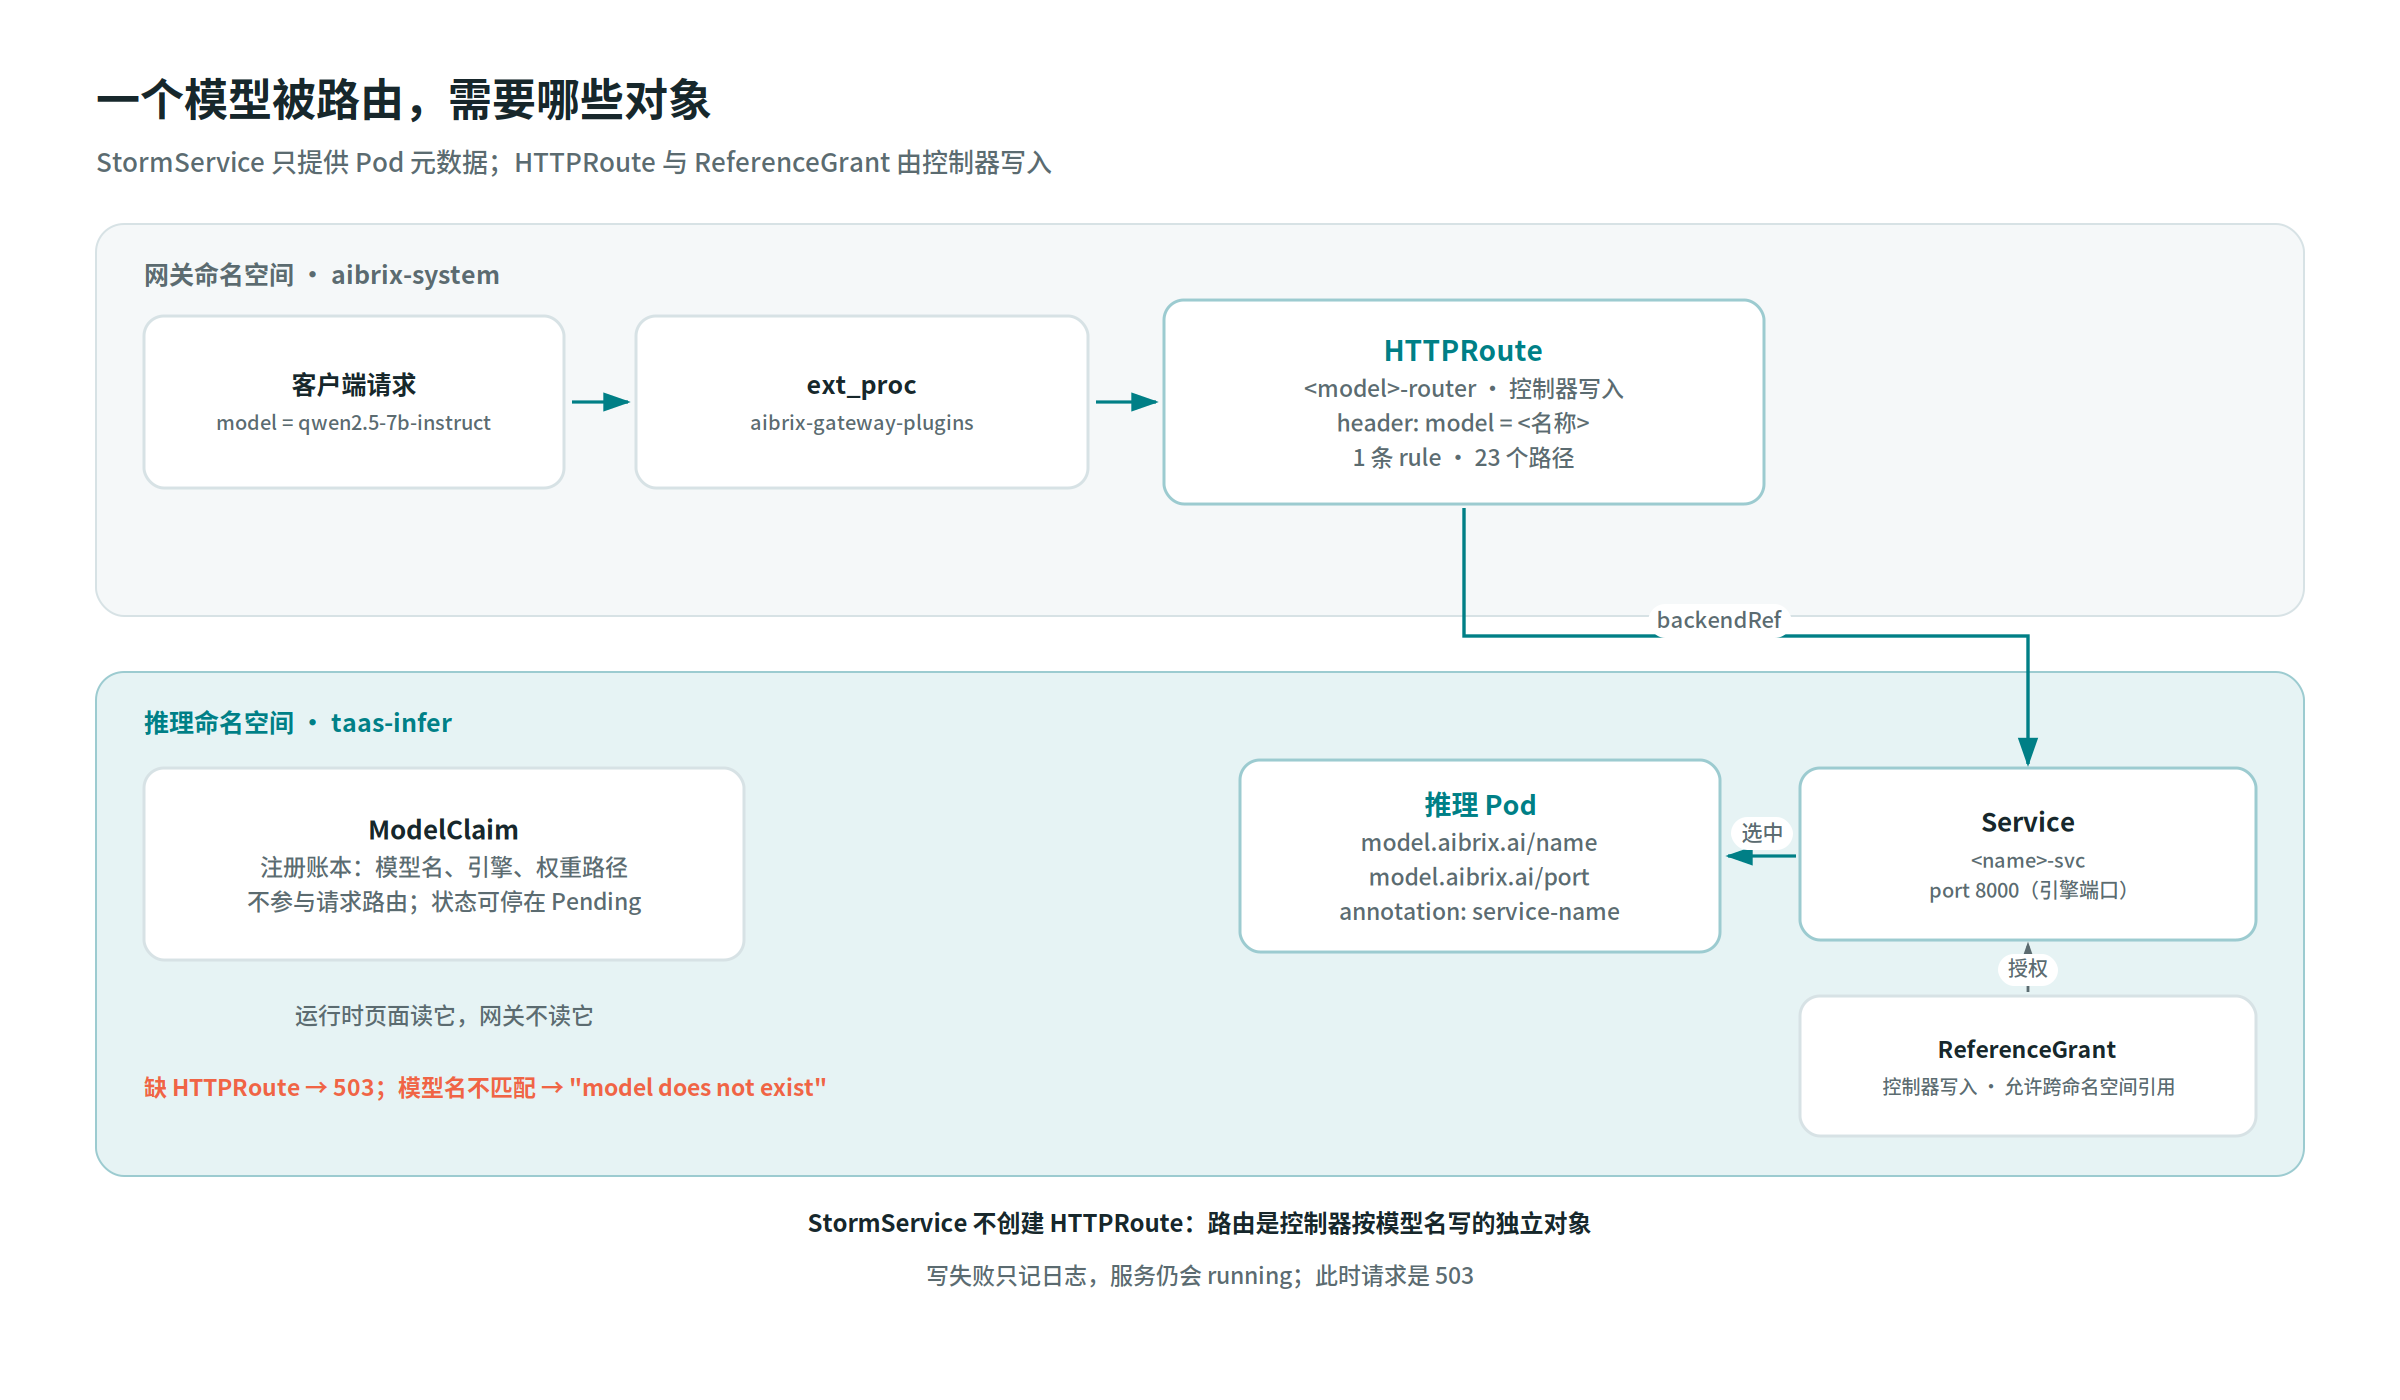
Pod 上写的是 model.aibrix.ai/name、model.aibrix.ai/port,以及注解 model.aibrix.ai/service-name(指向 <name>-svc,因为 Service 名和模型名不是一回事)。网关通过这些元数据建立“模型 → Pod”的表,再按模型名去找 <model>-router;找不到就返回 503。
路由本身是一条 rule、23 个路径前缀匹配项,每项都带同一个请求头精确匹配:
1 | apiVersion: gateway.networking.k8s.io/v1 |
路径集合、后端端口和超时都照抄 AIBrix 自己发布的 model route:port: 8000 是引擎端口(不是 Service 的 80),timeouts.request: 600s 是 AIBrix 的默认值。路由名也遵循 AIBrix 的规则,所以集群里即使同时跑着 AIBrix 的 model router,双方写的也是同一个对象,而不是各建一份。
这里有三个实现细节值得记住。
模型名不一定能当标签值。 Kubernetes 的标签值不允许 /,而模型目录里的 hub id 常常是 MiniMax/MiniMax-M3 这种形式。控制器的做法是:能当标签就写标签,不能就只写注解;网关先读标签,读不到再读注解。路由名也做同样的兜底:常规模型是 <model>-router,不符合 DNS-1123 子域规则的名字会转成小写、替换非法字符并追加 12 位哈希。这样即使集群里同时跑了 AIBrix 自己的 model router,两边也会收敛到同一个对象,而不是各建一份。
引擎必须接受目录里的模型名。 客户端发的是 model 字段里的名字,引擎默认只认启动参数里的权重目录。因此控制器总会追加 --served-model-name。漏掉它,网关能找到 Pod,引擎却会返回模型不存在。
路由写失败不会让服务失败。 applyModelRoute 是尽力而为的:失败只记日志,控制器继续等引擎就绪并发布 running。于是会出现一种很难排查的状态:控制台显示服务正常,所有请求却是 503。AIBrix 的报错很——路由缺失时是 httproutes.gateway.networking.k8s.io "<model>-router" not found。遇到 503,先查这条路由,再查 Pod 标签,通常比看引擎日志快。
删除服务时,storm、Service、ModelClaim、HTTPRoute 和 PodAutoscaler 都会被清理;ReferenceGrant 故意保留,它是命名空间级的,被该命名空间所有模型共用。删除 HTTPRoute 前会核对该对象的 go-taas.com/service-id,避免名字被新服务复用时,旧服务的删除事件误删新路由。
四、自动扩缩容:PodAutoscaler
推理服务的瓶颈通常不在 CPU。CPU 跑到 30% 时,GPU 可能已经在排队;CPU 跑到 80% 时,也可能只是 Python 进程在等锁。按 CPU 扩容,得到的是一个反应迟钝、还经常误判的副本数。
Go TaaS 交给 AIBrix 的指标是每个 Pod 的运行中请求数:
1 | apiVersion: autoscaling.aibrix.ai/v1alpha1 |
scaleTargetRef 指向 StormService,不是 Deployment。扩容 storm 的副本数,对每种拓扑都等于扩容服务的副本数:单机是一个 Pod,多机是一组 worker,PD 是一组按比例配置的 prefill + decode。
targetMetric 必须是 AIBrix 中央指标注册表里的名字。num_requests_running 会被解析成引擎实际暴露的 vllm:num_requests_running。如果这里写成朴素 HPA 路径用的 taas-infer-concurrency,准入 Webhook 会放行,但运行时的指标抓取每次都会报 “not found in central registry”,扩缩容永远不会发生。这类错误不会让服务挂掉,只会让它悄悄地不伸缩,所以指标名要按运行时的契约写。
targetValue 是每个 Pod 的目标并发,默认 32。它和组织级并发配额不是一回事:配额是控制面允许这个租户同时打多少请求,是上限;targetValue 是运行时希望每个 Pod 背多少请求,是工作点。把两者设成同一个数,通常会得到一个长期在最大值附近震荡的副本数。
scalingStrategy 固定为 HPA(后续可能会改为KPA或者APA,依赖于Aibrix社区的成熟度)。CRD 只接受 HPA、KPA、APA,空值会被 422 拒绝。选择 HPA 是为了保持与原有并发阈值语义一致,而不是因为这里真的有一个 Kubernetes HPA。
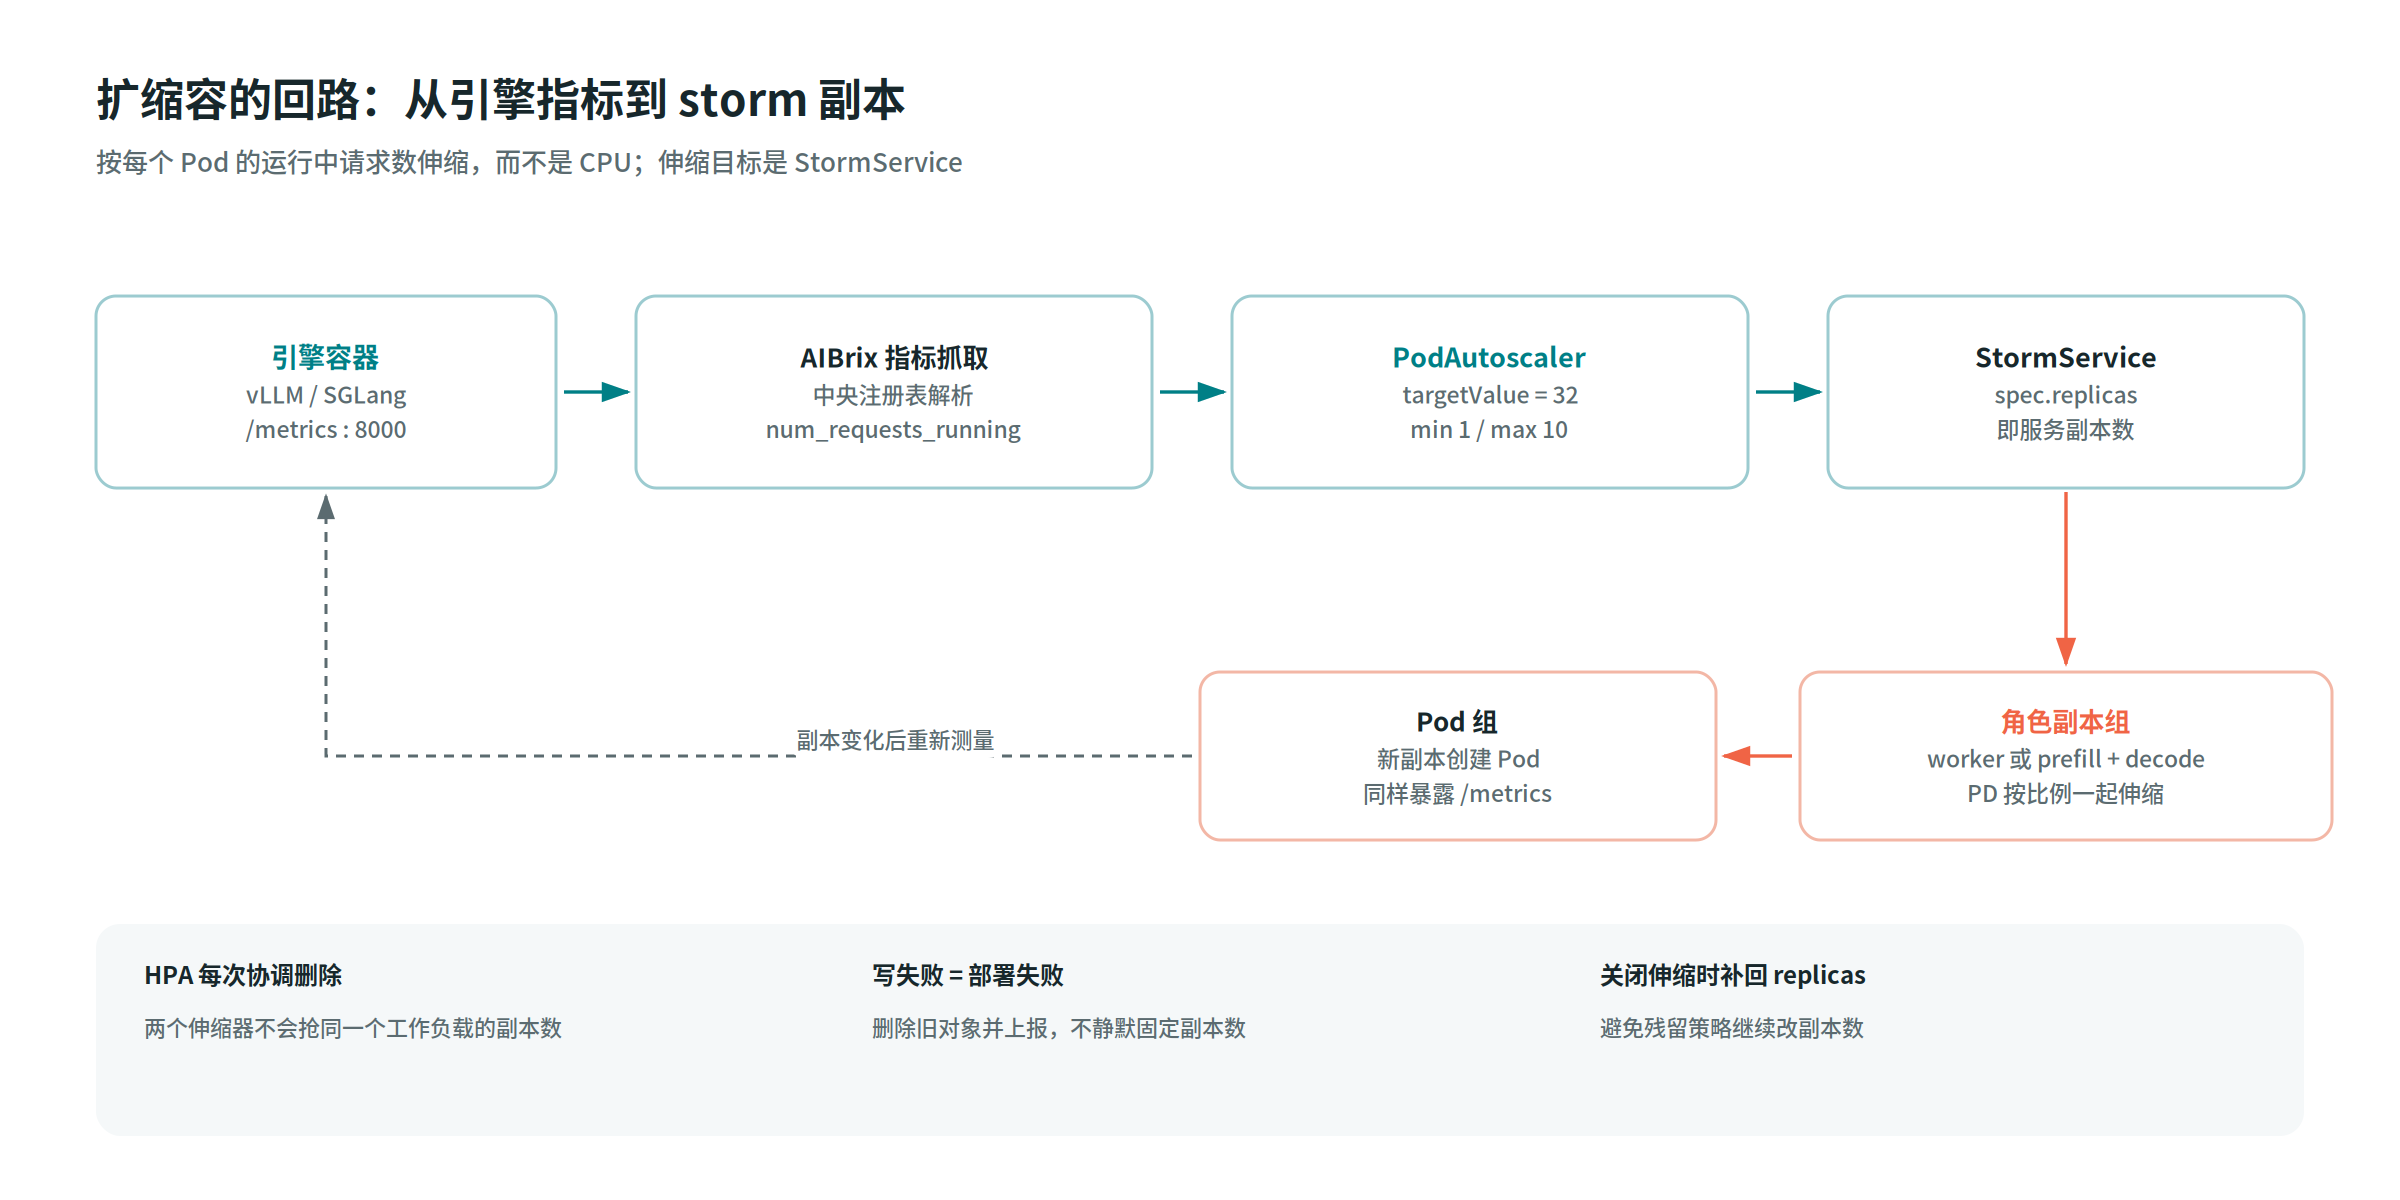
扩缩容的失败语义是显性的,这一点和很多“尽力而为”的控制器不同:
PodAutoscaler写失败,控制器会删掉可能存在的旧对象,然后把这次部署标记为失败。它不会静默地固定副本数,否则控制台会把一个没人伸缩的服务显示成“已自动扩缩容”。- 关闭自动扩缩容时,控制器删除
PodAutoscaler,并把 storm 的spec.replicas补丁回固定值,避免残留的扩缩容策略继续改副本数。 - 每次协调都会删除旧控制器留下的 Kubernetes HPA。留着它,HPA 和
PodAutoscaler会为同一个工作负载互相覆盖副本数。
AIBrix 的 PodAutoscaler 支持 subTargetSelector 做角色级扩缩容,但这里没有用。准入 Webhook 不允许它与 HPA 策略同时出现,而其它策略需要这套部署没有定义的额外基础设施。对 PD 来说,服务级扩缩容已经够用:prefill 与 decode 按各自的 role replicas 一起伸缩,比例由 prefill_replicas / decode_replicas 决定。
五、小结
推理与控制分离 编排、调度、扩缩容交给运行时;鉴权、限流、计量留在 TaaS 数据面的网关上。两边通过 Kubernetes 自定义资源和 Pod 元数据耦合,耦合面越窄,服务越稳定。
拓扑类型在创建推理时选择
single、multinode、pd存在数据库里,控制器把它翻译成角色集合。新增一种拓扑时,先想清楚它对应哪些角色、每个角色几个 Pod,而不是在控制器里再加一个if。多机与 PD 分离场景 rank 怎么获取、master 怎么找、
/dev/shm够不够、服务是否健康,这些问题都需要控制面和推理面一起来解决。路由 Pod 标签、HTTPRoute、ReferenceGrant 等 Gateway API 自定义资源缺一不可。LLM接口调不通时先
kubectl get这三个对象,再看引擎日志。扩缩容 指标名写错,准入能过、服务能跑、扩容永远不发生。这种静默失败比报错更难发现,需要关注 Aibrix 定义的指标名与代码中的是否一致。
失败语义需要区别定义。 鉴权 fail-closed,计量 fail-open,扩缩容失败必须显性失败,运行时采集失败保留最后已知状态。每一类故障的取舍都需要定义清楚。
AIBrix 提供的是一组原语,不是一套开箱即用的 TaaS 服务。StormService 解决“怎么跑”,ModelClaim 解决“怎么登记”,HTTPRoute 解决“怎么找到”,PodAutoscaler 解决“跑多少”。这些功能叠加上 TaaS 平台的权限、计量和账单上,推理服务才能成为Token工厂。
参考资料
- 项目主页:https://go-taas.com/
- 文档中心:https://go-taas.com/docs.html
- StormService 服务拓扑:https://go-taas.com/docs.html?doc=architecture/stormservice-serving-topology&lang=zh-CN
- 分布式推理运行时(AIBrix 集成):https://go-taas.com/docs.html?doc=architecture/distributed-inference-runtime&lang=zh-CN
- 数据面网关插件:https://go-taas.com/docs.html?doc=architecture/data-plane-gateway-plugin&lang=zh-CN
- 推理自动扩缩容:https://go-taas.com/docs.html?doc=architecture/inference-autoscaling&lang=zh-CN
- 安装与部署:https://go-taas.com/docs.html?doc=getting-started/installation&lang=zh-CN
- AIBrix 项目:https://github.com/vllm-project/aibrix
- Go TaaS 代码:https://github.com/go-taas/go-taas
 微信
- 支付宝