如何利用 HAMi 来提升 Token 工厂的 GPU 利用率
前面的文章提到过,提升集群的GPU利用率可以有效地降低 Token 工厂的成本。这句话说起来容易,落到 Kubernetes 上却有个硬约束:Kubernetes 只会按整数分配 GPU。一个申请 nvidia.com/gpu: 1 的 Pod 拿到整张卡,哪怕它的模型只需要 2 GiB 显存。而智能体常用的 rerank、embedding 模型都是这样的小模型,如果每个小模型都独占一张卡的话,GPU利用率肯定上不去。
本文讨论我们怎么把 HAMi 接进 Go TaaS,把一张物理卡切成几份分配给几个小模型,并且用一套可复现的基准测出真实收益——包括收益没有想象中大的地方。
1. HAMi 是什么
HAMi 全称 Heterogeneous AI Computing Virtualization Middleware(异构 AI 计算虚拟化中间件),前身是 k8s-vGPU-scheduler,目前是 CNCF 孵化项目。它解决的核心问题:让 Kubernetes 能把一张物理加速卡切开,分给多个容器,并且各自有边界。
工作原理
HAMi 由四个部分组成:
| 组件 | 形态 | 作用 |
|---|---|---|
| MutatingWebhook | hami-scheduler Deployment 的一部分 | 发现 Pod 申请了 HAMi 资源,把 schedulerName 改成 hami-scheduler |
| HAMi 调度器 | hami-scheduler Deployment(内嵌 kube-scheduler + extender) | 维护每张卡的余量视图,选节点、选卡,把结果写进 Pod 注解 |
| device plugin | 每个 GPU 节点一个 DaemonSet | 向 kubelet 上报设备,Pod 启动时把卡和 libvgpu.so 挂进容器 |
HAMi-Core(libvgpu.so) | 容器内 preload 的库 | 拦截 CUDA/NVML 调用,执行显存与算力限额 |
一个申请 nvidia.com/gpumem: 3000 的 Pod 的调度流程如下:
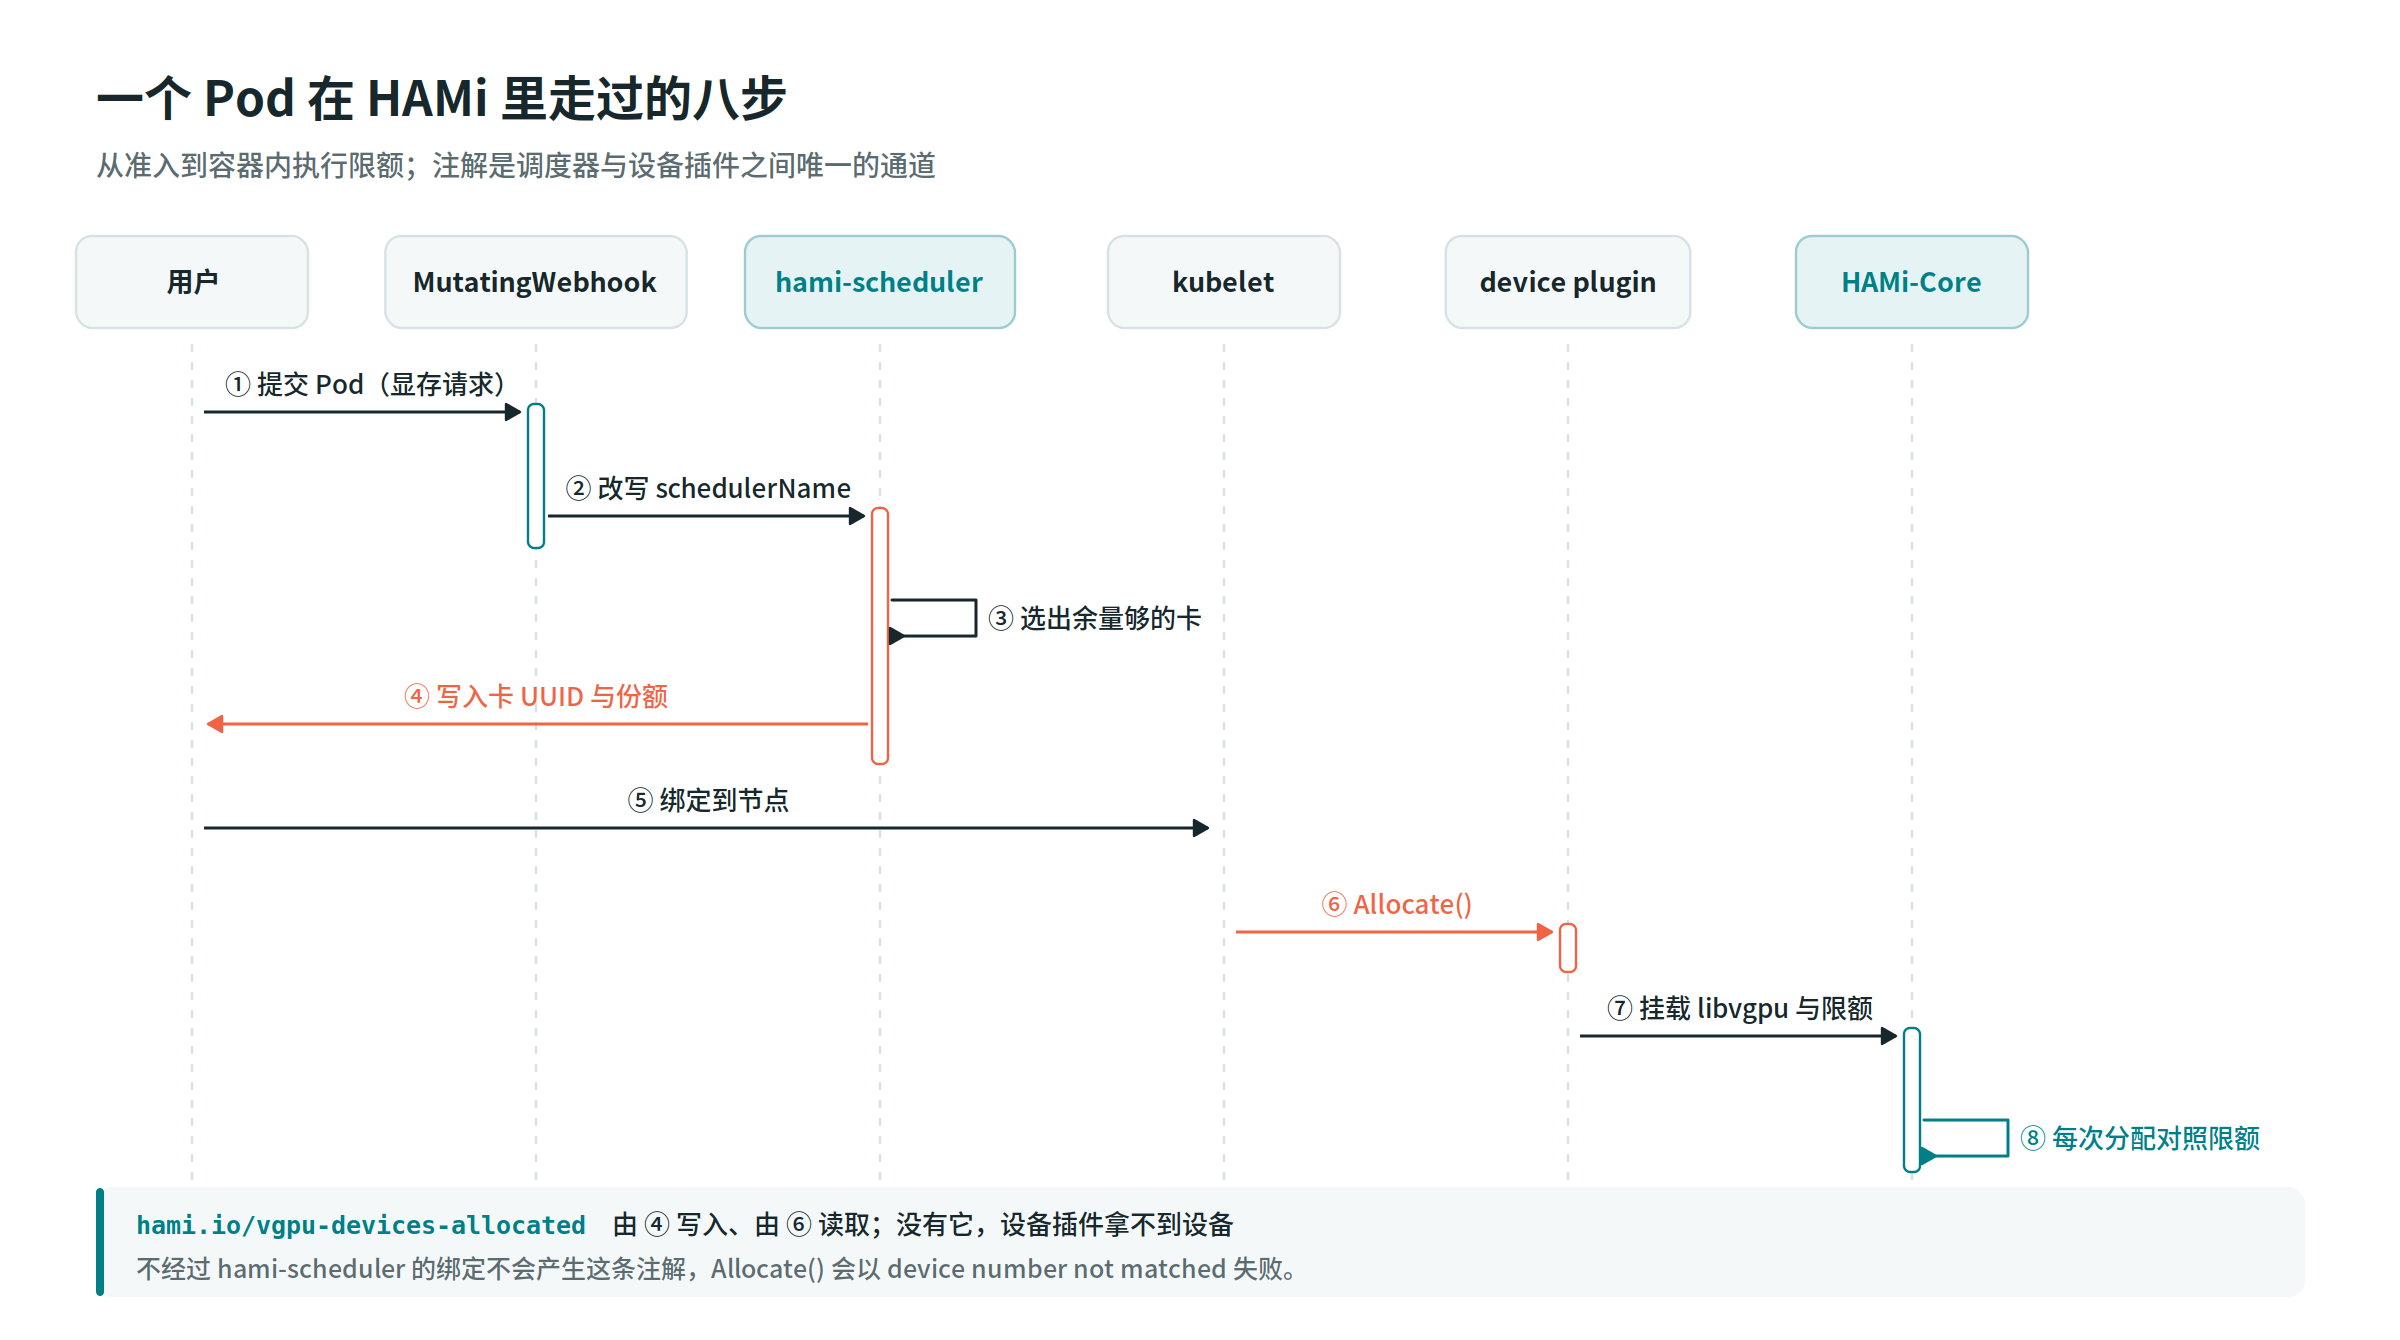
关键是第 4 步:只有 HAMi 调度器知道哪张卡还有余量,也只有它会写 hami.io/vgpu-devices-allocated 这个注解。device plugin 完全依赖这个注解来分配设备。把切片 Pod 交给 kube-scheduler 或 Volcano,Pod 会一直 Pending——这一点我们在集成时踩过一次。
资源模型
| 资源名 | 含义 |
|---|---|
nvidia.com/gpu | 申请的 vGPU 个数(必须带,它是设备插件注册的计数资源) |
nvidia.com/gpumem | 每个 vGPU 的显存,单位 MiB 的整数 |
nvidia.com/gpumem-percentage | 显存按卡容量百分比申请 |
nvidia.com/gpucores | 算力占比,5–100 |
nvidia.com/priority | 同卡容器的优先级,影响算力限速策略 |
这里得提一下容易踩坑的两个细节:
gpumem是纯 MiB 数值。写成6Gi会被当成 60 亿 MiB,等价于不限制。我们第一次就写成了6Gi,容器里nvidia-smi照样显示整卡的显存容量,但 Pod 看起来是成功的——这种”静默失效”最难查。gpucores不是硬隔离。HAMi-Core 用令牌桶控制 kernel 提交速率,后台线程采样 GPU 利用率来补令牌。官方文档明确了三种策略:default只在同卡有同/高优先级容器跑 kernel 时限速,force始终按配额限速,disable不限速。HAMi 不为 Pod 预留 SM,所以算力隔离是尽力而为。
隔离边界
| 维度 | 是否硬隔离 | 说明 |
|---|---|---|
| 显存 | 是 | 超出限额的分配返回 CUDA_ERROR_OUT_OF_MEMORY,只影响该容器 |
| 显存可见性 | 是 | 容器内 NVML 返回限额,nvidia-smi 的 total 就是切片大小 |
| 算力 | 否,尽力而为 | 令牌桶 + 采样,不预留 SM |
| 故障域 | 否 | 同卡容器共享同一个 CUDA 上下文与驱动 |
所以 HAMi 的缺点很明确:**它适合”多个小模型共享一张卡”,不适合”强 SLA 的多租户混部”**。后者应该上 MIG(硬件分区),代价是粒度固定、卡型受限。但是对于 Token 工厂而言,多租户隔离的是 Token 的使用,加速卡由厂商或者管理员统一调度,我们只需要在集群中划分出几个节点专门给 HAMi 使用即可。
2. 为什么 Token 工厂需要集成 HAMi
小模型的整卡浪费
我们在实验集群上跑了一个 Qwen2.5-0.5B(bf16,权重 954 MB)和一个 Qwen2.5-1.5B(2.0 GiB)。整卡部署时,vLLM 的日志是这样的:
1 | Model loading took 0.93 GiB memory and 3.80 seconds |
0.93 GiB 权重,却占了 19.89 GiB 的 KV cache。这不是浪费——vLLM 默认 gpu_memory_utilization=0.92,它会把可见显存的 92% 一次性预占成 KV cache,用更大的 batch 换更高的吞吐。这是对的做法。
问题在于 Kubernetes 的视角:这张卡”已分配”,第二个模型无论多小都排不上。从集群指标看,DCGM_FI_DEV_FB_USED 是 23299 / 24564 MiB,看起来”卡用满了”;从业务看,这张卡只服务一个 0.5B 模型。显存被预占,不等于算力被用满——实测这两张卡的 DCGM 利用率是 76.3% 和 84.8%(第 4 节)。
对一个按 token 计费的平台,这直接决定了单位卡能提供多少个可售模型。整卡模式下,2 张卡 = 2 个模型;每个新增的小模型都要一张新卡。
为什么不是 MIG,也不是 MPS
| 方案 | 为什么不用 |
|---|---|
| NVIDIA MIG | 卡型有限制;支持的数据中心卡也只有固定的几种切法(如 1g.5gb),切法由硬件枚举,不能按业务自定义 |
| CUDA MPS | 只做算力并行,不做显存隔离。一个进程 OOM 会拖垮同卡的其他进程 |
HAMi 是这三者之外的一层:显存硬限制 + 算力软限制 + 对应用零改动 + K8s 原生资源模型。对 Go TaaS 这种把”部署一个模型”做成表单操作的产品,应用无感知很重要 —— 我们不需要为了适配 HAMi 而改 YAML,更不需要改推理框架。
3. Go TaaS 是如何集成 HAMi 的
抽象设计
运营者的词汇是”池 + 模板”,不是注解,因此我们没有把 nvidia.com/gpumem / nvidia.com/gpucores 暴露给用户。让用户自己填显存和算力,容量规划就失效了。取而代之的是两层抽象:
- vGPU 池(pool):一组由节点标签指定的节点,例如
go-taas.com/vgpu-pool=pool-a。只有池里的节点才会被切片。 - 切片模板(template):池上允许用户(管理员)定义模板,例如
quarter = 6 GiB + 25%、half = 10 GiB + 50%。启动推理服务时选择模板即可。
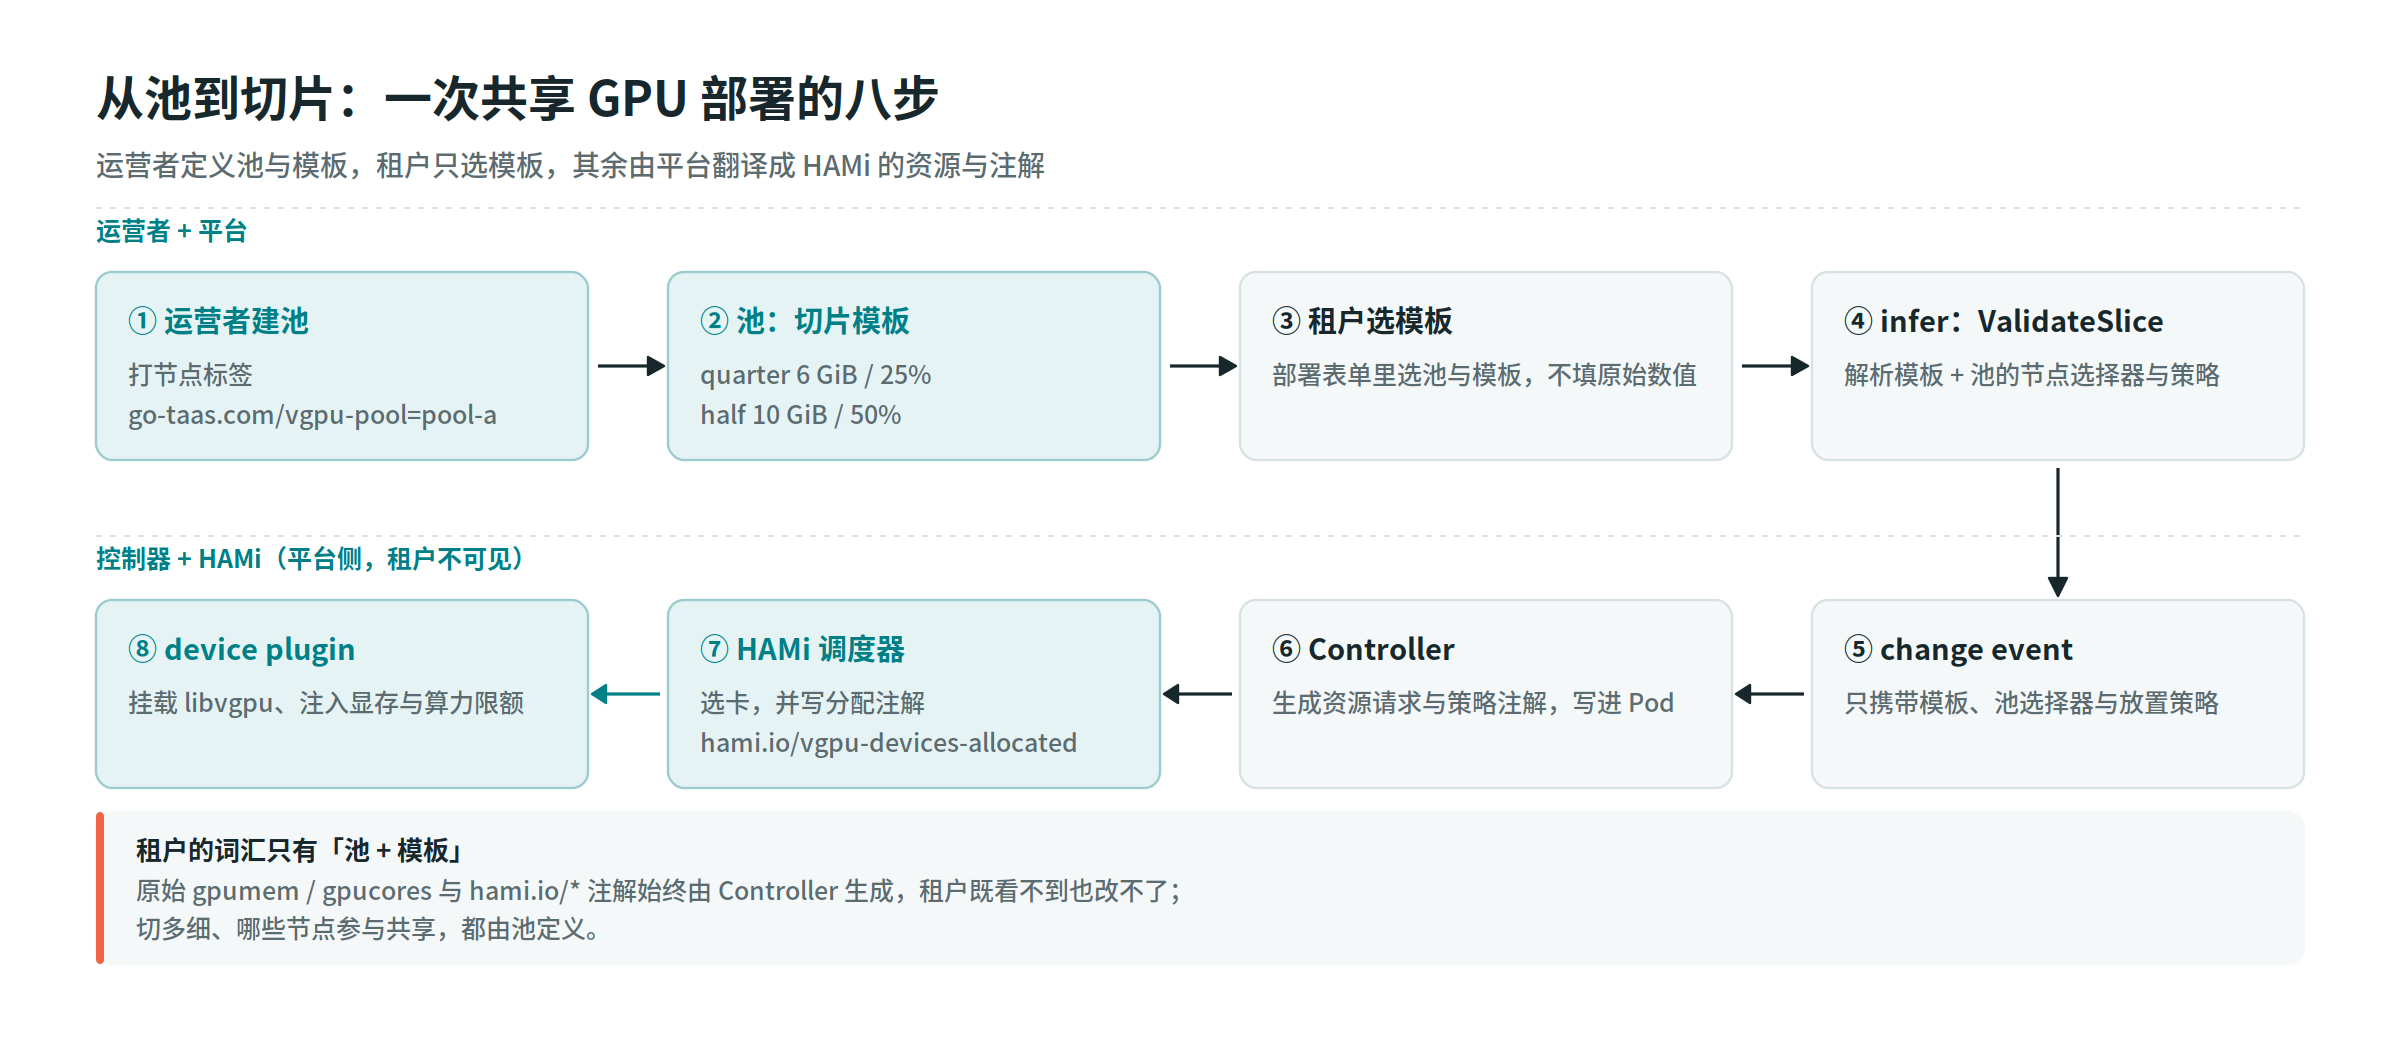
Controller 实际生成的东西
一个 quarter 模板(6 GiB / 25%)的服务,Pod 变成这样:
1 | spec: |
Pod 上的注解 hami.io/gpu-scheduler-policy: binpack 来自池的放置策略——这个注解现在真的生效了,因为切片 Pod 走的是 HAMi 调度器。
集成时遇到的问题
集成并不是一次就通的,这里记录一下遇到的问题:
问题 1:只请求 gpumem / gpucores,没有请求 nvidia.com/gpu。nvidia.com/gpumem 不是节点的 allocatable 资源,它只是 device plugin 读取的请求字段。少写 nvidia.com/gpu: 1,调度器看到的就是”这个 Pod 没申请任何 GPU 设备”,或者”申请了不存在的资源”,两种情况都不会绑定到正确的卡。
问题 2:gpumem 写成了 6Gi。resource.MustParse("6144Mi") 再序列化会变成 6Gi,而 HAMi 用 AsInt64() 取 MiB 数值。6Gi 被解析成约 6×10⁹ MiB,远大于卡容量,等于没有任何限制。容器里 nvidia-smi 仍然显示 24564 MiB,CUDA_DEVICE_MEMORY_LIMIT_0=0m:
1 | $ nvidia-smi --query-gpu=memory.total --format=csv,noheader |
改成不带单位的整数后正确切分:
1 | 6144 MiB |
问题 3:切片 Pod 没有交给 HAMi 调度器。
原实现沿用平台的 Volcano 调度器。Volcano 不认识 nvidia.com/gpumem,也不会写 hami.io/vgpu-devices-allocated,结果是 Pod 一直 Pending,事件里什么都没有。
这个问题还有第二层,比第一层更容易误判:装完 HAMi 之后,整卡 Pod 也必须交给 HAMi 调度器。因为 nvidia.com/gpu 已经由 HAMi 的 device plugin 接管,而它的 Allocate() 只从 Pod 注解里读设备列表(pkg/device-plugin/nvidiadevice/nvinternal/plugin/server.go):
1 | currentCtr, devreq, err := GetNextDeviceRequest(nvidia.NvidiaGPUDevice, *current) |
Pod 由 Volcano 绑定时,devreq 是空的(没有 HAMi 选卡的记录),设备数对不上,分配直接失败;kubelet 反复重试,Pod 在 Scheduled 与 Pending 之间循环,上游控制器则不断重建它。实测现象很容易误判:Volcano 的日志里是 bind ok,Pod 却永远不 Running。
所以正确的规则是:HAMi 接管设备资源的节点上,所有申请加速器的 Pod 都由 hami-scheduler 放置,整卡也一样。修复后切片 Pod 与整卡 Pod 都走 hami-scheduler,并验证整卡服务正常启动。
代价要说清楚:这些 Pod 就没有 gang 调度了——Pod 的 schedulerName 是 hami-scheduler,Volcano 永远不会读它的 PodGroup,所以我们把 PodGroup 的写入限定在”没有 HAMi”的情况下。如果既要 HAMi 切分、又要 gang 调度,需要改用 HAMi 的 Volcano 集成(Volcano 自己的 vGPU device plugin),那是另一套安装形态。
问题 4:vLLM 的默认 gpu_memory_utilization=0.92 在切片里必然 OOM。
HAMi 把 nvidia-smi 的 total 改成了切片大小,但 CUDA 的 mem_get_info 仍按切片算,于是引擎按 92% 预占、只留 8% 余量,而激活峰值和 CUDA graph 需要的不止 8%。实测 6144 MiB 的切片:
1 | Free memory on device (5.62/6.0 GiB) on startup. Desired GPU memory utilization is (0.92, 5.52 GiB). |
切片比整卡小得多,8% 的绝对余量也更小。我们把启用切片的推理服务的默认值降到 0.88(12% 余量),并保留运营者覆盖的能力。修复后同一个切片的日志:
1 | Free memory on device (5.62/6.0 GiB) on startup. |
问题 5:管理面看不到池成员。
accelerator inventory 只上报加速器相关标签(go-taas.com/accelerator、驱动版本、卡型号),把运营者自己打的 go-taas.com/vgpu-pool 过滤掉了。结果池的 nodeCount 是 1,但 nodes 是空数组,容量核算无从谈起。同时每张卡的清单也是空的——切片之后节点的 nvidia.com/gpu 是 vGPU 个数(20),不是物理卡数(2)。修复方式是上报所有 go-taas.com/* 标签,并从 HAMi 的节点注册注解 hami.io/node-nvidia-register 读每张卡的 index / 型号 / 显存。
修复后的验证
两个服务(0.5B quarter、1.5B half)被 HAMi 的 binpack 策略放到了同一张物理卡上:
1 | $ kubectl get pod -o jsonpath='{...annotations.hami\.io/vgpu-devices-allocated}' |
同一个 GPU UUID,6144 MiB/25% 与 10240 MiB/50%,都是从 hami-scheduler 拿到的。两个容器内的 nvidia-smi 分别只看到 6144 MiB 和 10240 MiB:
1 | $ kubectl exec <0.5B pod> -- nvidia-smi --query-gpu=memory.total --format=csv,noheader |
到这里,显存与算力的边界是真实存在的,而不是配置里的一个数字。
4. 集成 HAMi 之后 GPU 利用率的提升
测试环境与方法
| 项 | 值 |
|---|---|
| 集群 | RKE2 v1.36.2,Ubuntu 22.04.5,2 节点 |
| 切分池节点 | 2 × NVIDIA GeForce RTX 4090,24564 MiB/卡,驱动 595.91.07,CUDA 13.2 |
| HAMi | v2.9.0(chart 2.9.0),deviceSplitCount: 10 |
| 平台 | Go TaaS 1.118.1 |
| 推理引擎 | vLLM 0.28.0(vllm.entrypoints.openai.api_server) |
| 模型 | Qwen2.5-0.5B-Instruct(954 MB)、Qwen2.5-1.5B-Instruct(2.0 GiB),bf16 |
| 模型参数 | --max-model-len 4096 |
负载:固定的中文 prompt(89 token),max_tokens=128、temperature=0、ignore_eos=true,每个服务 N 并发,持续 60 s;先发一轮预热,不计入统计。
计量:
- 客户端统计 completion tokens/s、请求数、p50/p95/p99 延迟(
httpx异步压测脚本,跑在集群内的 Pod 里,直连 Service); - GPU 侧用集群已有的 DCGM exporter,
DCGM_FI_DEV_GPU_UTIL(有 kernel 运行的时间占比)与DCGM_FI_DEV_FB_USED(显存占用),2 s 采样,取压测窗口内均值。
为什么按”每卡并发”对齐:整卡方案是 1 个服务 8 并发/卡;切片方案是 2 个服务各 4 并发 = 8 并发/卡。这样比较的是”同一张卡、同样的请求压力,能产出多少 token”,而不是拿低并发和高并发对比。
基线:整卡独占
| 服务 | 模型 | 卡数 | tokens/s | req/s | p50 (ms) | p95 (ms) | p99 (ms) |
|---|---|---|---|---|---|---|---|
| whole-05b | Qwen2.5-0.5B | 1 | 3372.1 | 26.34 | 300.7 | 324.7 | 355.0 |
| whole-15b | Qwen2.5-1.5B | 1 | 1513.8 | 11.83 | 674.5 | 691.8 | 706.1 |
DCGM(60 s 窗口均值):卡 0 利用率 **76.3%**,卡 1 **84.8%**;显存占用 23299 / 23019 MiB。
值的注意的是:**显存占用 94%,但算力只用了 76–85%**。这就是”整卡分配”的真实问题——显存被 vLLM 预占满,算力仍有 15–24% 的空隙无法利用。
切片:一张卡两个模型(25% + 50%)
切分池策略 binpack,每卡放一个 quarter(0.5B)和一个 half(1.5B),每个推理服务 4 并发。
| 服务 | 模板 | 物理卡 | tokens/s | req/s | p50 (ms) | p95 (ms) | p99 (ms) |
|---|---|---|---|---|---|---|---|
| slice-05b-1 | quarter 6 GiB/25% | GPU-e447… | 663.5 | 5.18 | 777.9 | 794.3 | 803.0 |
| slice-15b-1 | half 10 GiB/50% | GPU-e447… | 238.3 | 1.86 | 2190.4 | 2232.6 | 2565.8 |
| slice-05b-2 | quarter 6 GiB/25% | GPU-8b2f… | 661.7 | 5.17 | 775.3 | 797.8 | 877.5 |
| slice-15b-2 | half 10 GiB/50% | GPU-8b2f… | 746.7 | 5.83 | 679.7 | 694.0 | 1004.6 |
合计 2310 tokens/s(2 张卡,4 个推理服务);DCGM指标:卡 1 **100%**,卡 0 **76.6%**。
需要解释如下两个现象:
第一,总吞吐低于整卡。 整卡双服务是 4886 tokens/s,切片双服务是 2310 tokens/s。原因是:25% + 50% = 75% 加速卡的算力配额先砍掉 1/4;两个引擎在同一张卡上时间片轮转,KV cache 反复换入换出,再损失一部分。HAMi 不为切片预留 SM,这个代价是必然的。
第二,同规格的两个服务吞吐差 3 倍(238 对 747)。它们配额相同、邻居规格相同,差异来自 HAMi 的算力限制实现:令牌桶按采样窗口补令牌,default 策略下只有”同卡有同/高优先级容器在跑 kernel”时才限速。采样与调度的时序决定了谁在什么时刻被限流,不保证按配额严格成比例。所以 238 这个数字不是”1.5B 只需要 238 tokens/s”,而是”这一轮它被限得更狠”。要拿延迟做 SLO,得靠保守配额、独立池,或把关键服务放到整卡上。
切片:一张卡三个同规格模型(3 × 25%)
为了看”密度”的极限,我们在一张卡上放了 3 个 0.5B、都是 quarter(6 GiB/25%),每个 3 并发(合计 9 并发/卡,与基线的 8 并发基本对齐)。
| 服务 | 物理卡 | tokens/s | p50 (ms) | p95 (ms) |
|---|---|---|---|---|
| dense-1 | GPU-e447… | 481.4 | 797.4 | 814.4 |
| dense-2 | GPU-e447… | 486.7 | 786.7 | 809.1 |
| dense-3 | GPU-e447… | 479.2 | 797.5 | 812.7 |
| 合计 | 1447.3 |
DCGM:该卡利用率 **100%**,显存峰值 19165 MiB。
对照组:同一个 25% 切片独占一张卡(邻居空闲)时是 1318.7 tokens/s、p50 287.7 ms、利用率 54.9%、显存 6391 MiB。
把两组放在一起,结论就出来了:
1 | 1 个 25% 切片独占卡: 1318.7 tok/s 利用率 54.9% 1 个模型 |
同一张卡的 token 产出基本不变(+9.7%),可跑的推理服务数变成 3 倍,GPU 利用率从 55% 变成 100%。 这 9.7% 的增量来自三个引擎的请求互相填补了对方的批处理空隙——单引擎在 3 并发下等请求,三引擎叠加后 GPU 很少空转。
结果对比
| 维度 | 整卡 | 切片(25%+50%) | 切片(3×25%) |
|---|---|---|---|
| 每卡模型数 | 1 | 2 | 3 |
| 2 张卡可上线模型数 | 2 | 4 | 6(按同规格推算) |
| 每卡 tokens/s(同并发) | 2443 | 1155 | 1447 |
| 单模型 p50 | 300–675 ms | 680–2190 ms | ~790 ms |
| GPU 利用率(DCGM) | 76–85% | 76–100% | 100% |
| 显存边界 | 无 | 6 / 10 GiB 硬限制 | 6 GiB 硬限制 |
结论如下:
- 收益在”密度”和”边界”,不在”同一负载跑得更快”。 如果负载不变、模型不变,切片只会更慢——多出来的上下文切换和算力配额就是成本。切片的价值出现在”卡不够、模型很多”的场景:4 个小模型 2 张卡,整卡方案根本部署不了,只能加卡。
- GPU 利用率提升 整卡方案的显存占用是 94%,看起来”用满了”;DCGM 利用率只有 76–85%。切片后显存占用反而降到 19 GiB,利用率却到 100%。按显存做容量规划会得出完全相反的结论。
- 单位 token 的算力成本不一定下降
当利用率提升所带来的“固定成本摊薄效应”,大于 HAMi 软件切分所引入的“有效吞吐量损失”时,单位 token 的成本才会真实下降。
如果 HAMi 把一张原本大量闲置的卡切分后,填充了大量原本无法被服务的小任务,使得总有效 token 产出显著增加,那么成本下降是成立的。但如果切分后,多个任务在软件层竞争同一张卡的计算资源,导致整体 MFU 下降,吞吐量的损失就可能抵消甚至超过利用率提升带来的好处。
因此,衡量 HAMi 经济性的最终指标,不应是简单的“GPU 利用率”,而应是在给定延迟 SLA 下,每卡每小时能产出的有效 token 数(tokens/GPU-hour)。只有这个指标上升,单位 token 的成本才真正下降。
部署问题
- **
DEVICE_DISCOVERY_STRATEGY=nvml**:默认的auto依赖ResolvePlatform()探测,在 RKE2 + GPU Operator 的节点上会落到Incompatible strategy detected auto。显式指定可以跳过探测。 - **
nvidiaDriverRoot: "/"**:驱动装在宿主机/usr/lib/x86_64-linux-gnu,/run/nvidia/driver是个空目录(GPU Operator 只建了骨架)。指到/run/nvidia/driver会导致NVML ERROR_LIBRARY_NOT_FOUND。
另外要关掉 GPU Operator 的 device plugin,否则它会和 HAMi 抢着向 kubelet 注册 nvidia.com/gpu:
1 | kubectl patch clusterpolicy cluster-policy --type merge \ |
5. 小结
HAMi 是什么:Kubernetes 上的 GPU 切分层。它把”一张卡”变成”若干个有显存与算力边界的 vGPU”,靠 webhook + 调度器 + device plugin + 容器内 libvgpu.so 四段协作完成,对应用零改动。
为什么 Token 工厂需要它:小模型占不满卡,是推理负载的结构性特征。整卡分配下,0.5B 模型会把 24 GB 卡的 94% 显存预占成 KV cache,第二个模型无处安放;而卡的算力只用了 76–85%。
Go TaaS 怎么集成:把运营者的”池 + 模板”翻译成 HAMi 的资源请求与注解。
实测收益(2 × RTX 4090,Qwen2.5-0.5B / 1.5B):
| 整卡 | 切片 | |
|---|---|---|
| 每卡模型数 | 1 | 2–3 |
| 2 卡可上线模型数 | 2 | 4–6 |
| GPU 利用率(DCGM) | 76–85% | 100%(3 切片同卡) |
| 每卡 tokens/s(同并发) | 2443 | 1155–1447 |
HAMi 不会让一张卡产出更多 token。但它让一张卡能同时服务更多模型,并且给每个模型划出硬边界。对 Token 工厂,这解决的是”卡不够、小模型很多”这个具体问题——把 2 张卡的供给从 2 个模型变成 4–6 个模型,扩容粒度从一张卡变成 6 GiB 显存 + 25% 算力。
什么时候不该用:模型的权重加 KV cache 本身就接近吃满一张卡,或者对延迟有硬 SLO 的场景。前者是因为没有切分的空间,后者是因为 HAMi 的算力隔离是尽力而为,无法承诺。这种情况下,整卡 + 独占仍是正确选择——HAMi 只是多了一个可选项,不是所有场景的更优解。
 微信
- 支付宝